واحد پردازش عصبی یا NPU یکی از بخشهای سختافزاری جدید در بعضی لپتاپها و کامپیوترهای مجهز به هوش مصنوعی است. با این حال، وجود NPU بهتنهایی به معنی سریعتر اجرا شدن همه مدلهای هوش مصنوعی نیست. در برخی کارها، پردازنده گرافیکی مجتمع یا حتی CPU عملکرد بهتری دارد؛ درحالیکه NPU میتواند برای پردازشهای کممصرف و پسزمینه، مانند تبدیل صدا به متن، انتخاب مناسبی باشد.
برای استفاده از این تراشه هم دیگر همیشه به قابلیتهای اختصاصی Copilot+ ویندوز محدود نیستید. ابزارهایی مانند Lemonade و FastFlowLM امکان اجرای بعضی مدلهای هوش مصنوعی محلی را روی NPU فراهم میکنند. در ادامه بررسی میکنیم این ابزارها چگونه کار میکنند و NPU در عمل برای چه کارهایی ارزش استفاده دارد.
NPU چیست و چگونه میتوان از آن برای اجرای هوش مصنوعی استفاده کرد؟
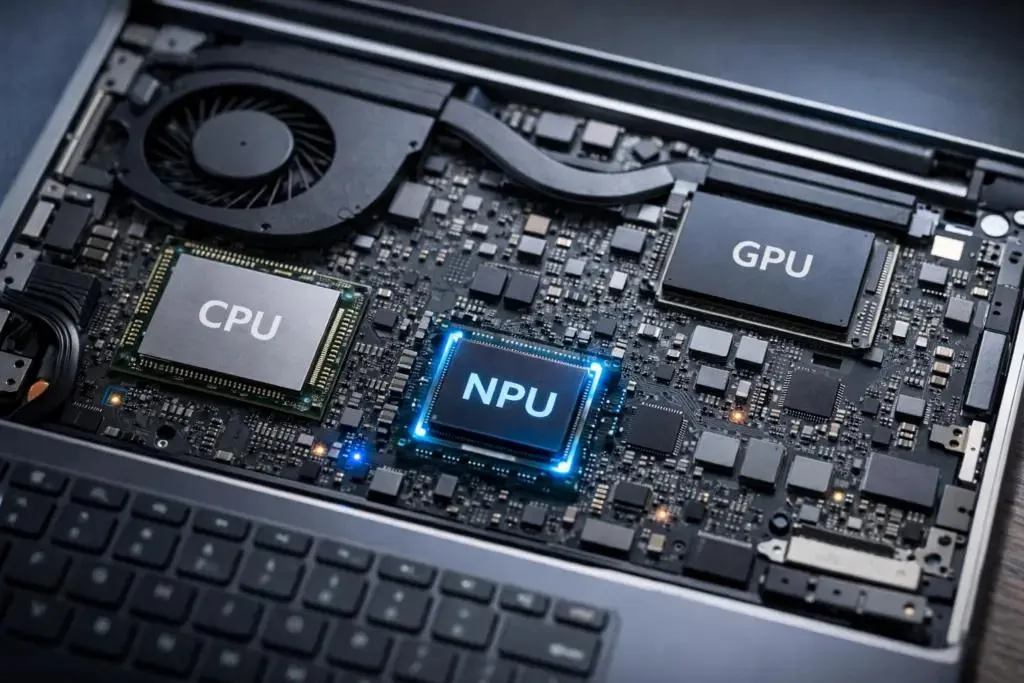
NPU مخفف Neural Processing Unit و به معنی واحد پردازش عصبی است. این تراشه برای اجرای محاسبات مرتبط با هوش مصنوعی طراحی شده و میتواند بخشی از پردازشهایی را که قبلاً به CPU یا GPU سپرده میشدند، با مصرف انرژی کمتر انجام دهد.
تفاوت NPU با پردازندههای دیگر در نوع وظیفهای است که برای آن بهینه شده است. CPU برای اجرای طیف گستردهای از دستورها کاربرد دارد و GPU در پردازشهای موازی و سنگین عملکرد خوبی نشان میدهد؛ اما NPU برای اجرای برخی محاسبات شبکههای عصبی و مدلهای هوش مصنوعی ساخته شده است.
در لپتاپهای مجهز به پردازندههای AMD Ryzen AI، این واحد سختافزاری میتواند برای اجرای مدلهای زبانی، پردازش صدا و تبدیل گفتار به متن استفاده شود. البته همه مدلها و همه نسخههای NPU با یکدیگر سازگار نیستند و برای استفاده از شتابدهی سختافزاری باید مدل و نرمافزار مناسب را انتخاب کنید.
تفاوت NPU با CPU و GPU در اجرای مدلهای هوش مصنوعی
هر سه واحد پردازشی میتوانند در اجرای هوش مصنوعی نقش داشته باشند، اما عملکرد و کاربرد آنها یکسان نیست:
- CPU: برای اجرای عمومی برنامهها و پردازشهایی که به انعطافپذیری نیاز دارند مناسب است. بسیاری از مدلهای هوش مصنوعی را میتوان حتی بدون GPU و NPU روی پردازنده اصلی اجرا کرد؛ البته سرعت ممکن است پایینتر باشد.
- GPU: به دلیل توان پردازش موازی بالا، برای اجرای مدلهای زبانی بزرگ و تولید سریع پاسخها مناسب است. اگر مدل به حافظه و پهنای باند زیادی نیاز داشته باشد، GPU معمولاً انتخاب قدرتمندی خواهد بود.
- NPU: برای اجرای محاسبات مشخص هوش مصنوعی با مصرف انرژی پایینتر طراحی شده است. این ویژگی آن را برای کارهای پسزمینه و پردازشهایی که لازم نیست با بیشترین سرعت ممکن انجام شوند، کاربردی میکند.
بنابراین نمیتوان گفت NPU همیشه از CPU و GPU سریعتر است. انتخاب واحد پردازشی مناسب به نوع مدل، اندازه آن، نرمافزار اجراکننده و سختافزار کامپیوتر بستگی دارد.
آیا برای استفاده از NPU به کامپیوتر Copilot+ نیاز داریم؟
خیر. قابلیتهای Copilot+ فقط یکی از کاربردهای NPU هستند و استفاده از این تراشه به امکانات اختصاصی مایکروسافت محدود نمیشود. نرمافزارهای دیگری نیز میتوانند مدلهای هوش مصنوعی را مستقیماً روی NPU اجرا کنند.
با این حال، پشتیبانی سختافزاری اهمیت زیادی دارد. به عنوان مثال، FastFlowLM برای شتابدهی NPU به نسلهای مشخصی از پردازندههای Ryzen AI با معماری XDNA2 نیاز دارد. بنابراین صرف وجود عبارت Ryzen AI روی نام پردازنده برای اطمینان از سازگاری کافی نیست و باید نسل تراشه و پشتیبانی نرمافزار را بررسی کنید.
اجرای مدل هوش مصنوعی روی NPU با Lemonade و FastFlowLM
یکی از راههای استفاده از NPU، اجرای مدلهای هوش مصنوعی بهصورت محلی روی کامپیوتر است. در این روش، مدل بهجای ارسال درخواستها به سرورهای اینترنتی، روی سختافزار خودتان اجرا میشود. این کار میتواند به حفظ حریم خصوصی کمک کند و برای استفاده از مدلهای سازگار، وابستگی به سرویسهای ابری را کاهش دهد.
دو ابزار مهم در این زمینه Lemonade و FastFlowLM هستند. Lemonade محیطی برای مدیریت و اجرای مدلهای هوش مصنوعی محلی فراهم میکند و میتواند از چند موتور پردازشی مختلف استفاده کند. FastFlowLM نیز یک موتور اجرای مدل است که بهطور ویژه برای NPUهای سازگار AMD بهینه شده است.
FastFlowLM چیست و چه مدلهایی را اجرا میکند؟
FastFlowLM یک موتور اجرای مدل هوش مصنوعی است که برای استفاده از NPUهای AMD Ryzen AI طراحی شده است. این ابزار میتواند مدلهای زبانی و برخی مدلهای مرتبط با پردازش صدا و بردارسازی اطلاعات را روی NPU اجرا کند.
از کاربردهای آن میتوان به موارد زیر اشاره کرد:
- اجرای مدلهای زبانی برای پرسش و پاسخ و تولید متن
- استفاده از مدلهای Whisper برای تبدیل گفتار به متن
- اجرای مدلهای Embedding برای جستوجوی معنایی در اسناد
- پردازش برخی مدلهای چندوجهی و مدلهای ترکیبی
FastFlowLM در قالب پروژه متنباز AMD و در کنار اکوسیستم ROCm توسعه پیدا کرده است. البته پشتیبانی از یک خانواده مدل به معنی سازگاری تمام نسخهها و اندازههای آن نیست؛ مدل باید نسخه بهینهشده و سازگار با NPU داشته باشد.
اجرای مدل محلی با Lemonade چه مزیتی دارد؟
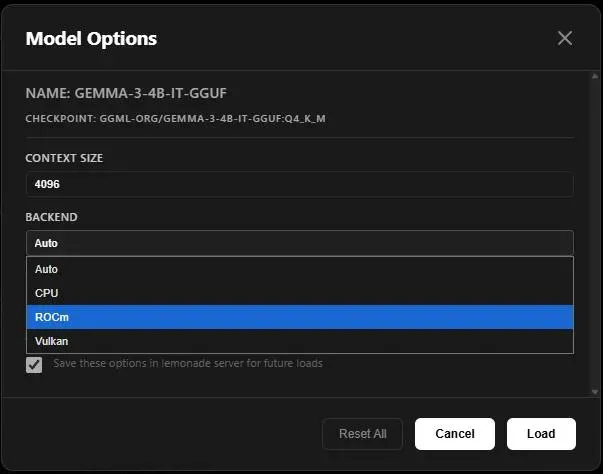
Lemonade امکان انتخاب و اجرای مدلهای مختلف را از طریق یک محیط یکپارچه فراهم میکند. این نرمافزار میتواند با توجه به مدل و سختافزار، از موتورهای متفاوتی مانند FastFlowLM و llama.cpp استفاده کند.
یکی از مزیتهای مهم این ساختار، امکان جابهجایی میان NPU و GPU است. به عنوان مثال، میتوانید برای یک مدل از NPU استفاده کنید و برای مدل دیگری که به سرعت تولید پاسخ بیشتری نیاز دارد، پردازنده گرافیکی را انتخاب کنید.
Lemonade همچنین امکان ارائه رابط سازگار با APIهای متداول هوش مصنوعی را فراهم میکند؛ بنابراین برنامههای دیگر نیز میتوانند به مدل محلی متصل شوند، بدون اینکه الزاماً مستقیماً با جزئیات سختافزار درگیر باشند.
آیا FastFlowLM روی همه پردازندههای Ryzen AI اجرا میشود؟
خیر. سازگاری به نسل NPU و نرمافزار مورد استفاده بستگی دارد. FastFlowLM برای شتابدهی NPU به تراشههای دارای معماری XDNA2 نیاز دارد. برخی پردازندههای قدیمیتر Ryzen AI با معماری XDNA1 ممکن است NPU داشته باشند، اما لزوماً از اجرای مدلها با FastFlowLM پشتیبانی نمیکنند.
در حال حاضر، خانوادههایی از Ryzen AI سری ۳۰۰ و ۴۰۰ و برخی مدلهای Ryzen AI Max و Z2 Extreme در فهرست سختافزارهای پشتیبانیشده قرار دارند. پیش از نصب نرمافزار، مدل دقیق پردازنده، نسخه درایور NPU و نیازمندیهای سیستمعامل را بررسی کنید.
عملکرد واقعی NPU در اجرای چت، تبدیل صدا به متن و جستوجوی اسناد
مهمترین نکته درباره NPU این است که مصرف انرژی پایینتر آن لزوماً به معنی سرعت بیشتر یا بهرهوری بهتر در تمام کارها نیست. نتیجه به نوع پردازش بستگی دارد و ممکن است یک مدل روی GPU چند برابر سریعتر از NPU اجرا شود.
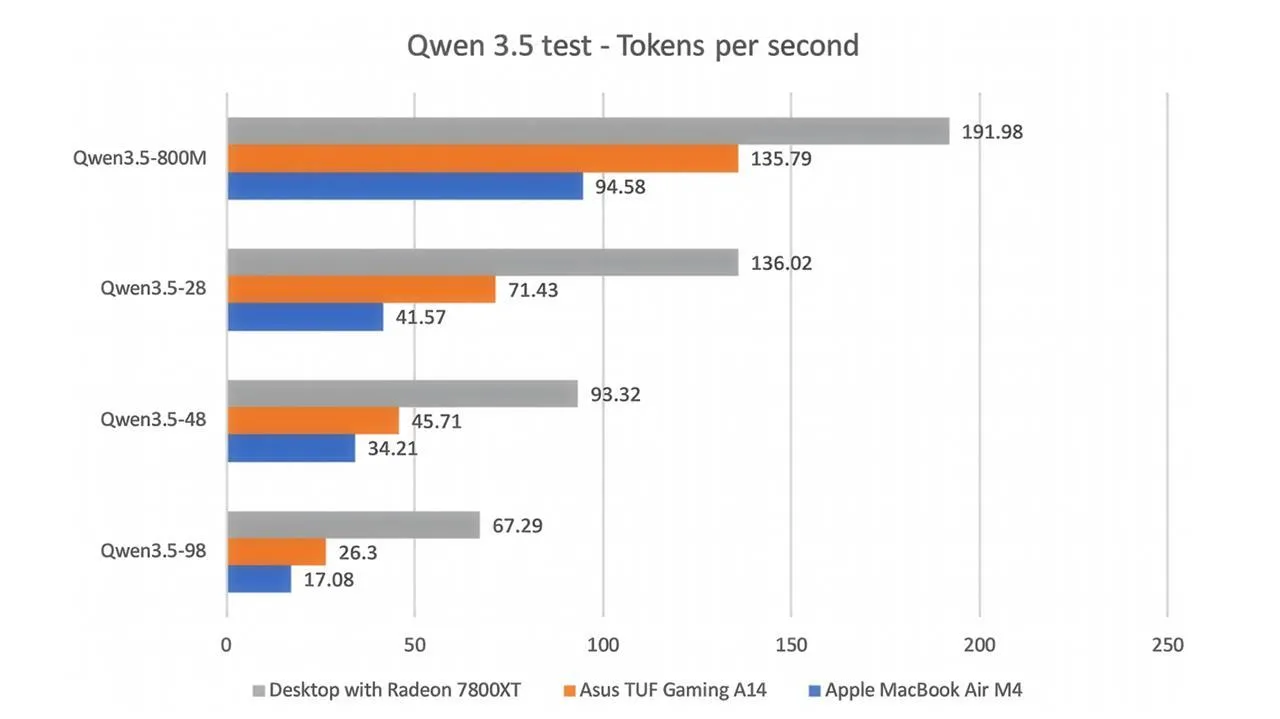
در یک آزمایش روی لپتاپ مجهز به AMD Ryzen AI، مدل زبانی gpt-oss-20b با چند روش مختلف اجرا شد. پردازنده گرافیکی مجتمع Radeon در این آزمایش حدود ۵۳٫۸ توکن در ثانیه تولید کرد؛ درحالیکه سرعت FastFlowLM روی NPU بهطور میانگین حدود ۹٫۵ توکن در ثانیه بود. اجرای مدل روی CPU نیز حدود ۲۳٫۶ توکن در ثانیه سرعت داشت.
این اعداد مربوط به همان دستگاه و شرایط آزمایش هستند و نباید آنها را به تمام لپتاپهای مجهز به NPU تعمیم داد. با این حال، نشان میدهند که برای گفتوگوی سریع با مدلهای زبانی، GPU میتواند انتخاب بهتری باشد.
چرا NPU برای چت با هوش مصنوعی همیشه بهترین انتخاب نیست؟
در گفتوگوی متنی، سرعت تولید پاسخ اهمیت زیادی دارد. کاربر انتظار دارد پس از ارسال پرسش، مدل در زمان کوتاهی شروع به پاسخگویی کند و متن را با سرعت مناسبی تولید کند.
اگر NPU یک مدل را با سرعت پایینتری اجرا کند، حتی مصرف انرژی کمتر آن هم لزوماً تجربه بهتری ایجاد نمیکند. در آزمایش یادشده، GPU مجتمع هم سریعتر پاسخ را آغاز کرد و هم توکنها را با سرعت بیشتری تولید کرد.
البته نتیجه برای همه مدلها یکسان نیست. اندازه مدل، نوع کوانتیزهسازی، طول ورودی و میزان سازگاری موتور اجرا با معماری NPU میتوانند عملکرد را تغییر دهند. به همین دلیل بهتر است پیش از انتخاب سختافزار، بنچمارک همان مدل روی دستگاه موردنظر را بررسی کنید.
چرا تبدیل گفتار به متن یکی از کاربردهای مناسب NPU است؟
تبدیل گفتار به متن از کاربردهایی است که میتواند با ویژگیهای NPU سازگاری خوبی داشته باشد. به عنوان مثال، هنگام تبدیل صدای یک جلسه چنددقیقهای به متن، همیشه لازم نیست پردازش با بیشترین سرعت ممکن انجام شود؛ مهمتر این است که بتوان آن را با مصرف انرژی کنترلشده و بدون اشغال مداوم GPU انجام داد.
مدل Whisper یکی از گزینههای شناختهشده برای تبدیل گفتار به متن است. در صورت استفاده از نسخه سازگار با NPU، میتوان پردازش صدا را به این واحد سپرد و منابع گرافیکی را برای اجرای بازی یا نرمافزارهای دیگر آزاد نگه داشت.
البته سرعت و دقت خروجی به مدل، زبان فایل صوتی، کیفیت ضبط و موتور اجرا بستگی دارد. همچنین اجرای یک مدل روی NPU الزاماً به معنی تولید متن دقیقتر نیست؛ مزیت اصلی میتواند آزاد ماندن سایر منابع سختافزاری و کاهش توان مصرفی بخش پردازش باشد.
جستوجوی اسناد با مدل Embedding روی NPU چه محدودیتهایی دارد؟
مدلهای Embedding متن را به بردارهای عددی تبدیل میکنند تا نرمافزار بتواند اسناد و عبارتهای مرتبط را بر اساس مفهوم آنها پیدا کند. این روش در جستوجوی معنایی و سیستمهای پرسش و پاسخ مبتنی بر اسناد کاربرد دارد.
اما اجرای مدل Embedding روی NPU بهتنهایی تضمین نمیکند که نتایج جستوجو دقیق باشند. کیفیت مدل، روش تقسیم متن به بخشهای کوچکتر و الگوریتم رتبهبندی نتایج اهمیت زیادی دارند.
در برخی آزمایشها، مدل Embedding ممکن است عبارتهایی را که از نظر معنایی ارتباط کمی دارند، در رتبههای بالاتر قرار دهد. ترکیب جستوجوی معنایی با جستوجوی کلیدواژهای میتواند چنین مشکلاتی را کاهش دهد. پس از پیدا شدن بخش مرتبط سند نیز یک مدل زبانی میتواند پاسخ نهایی را بر اساس همان اطلاعات تولید کند.
چگونه میزان استفاده NPU را در ویندوز بررسی کنیم؟
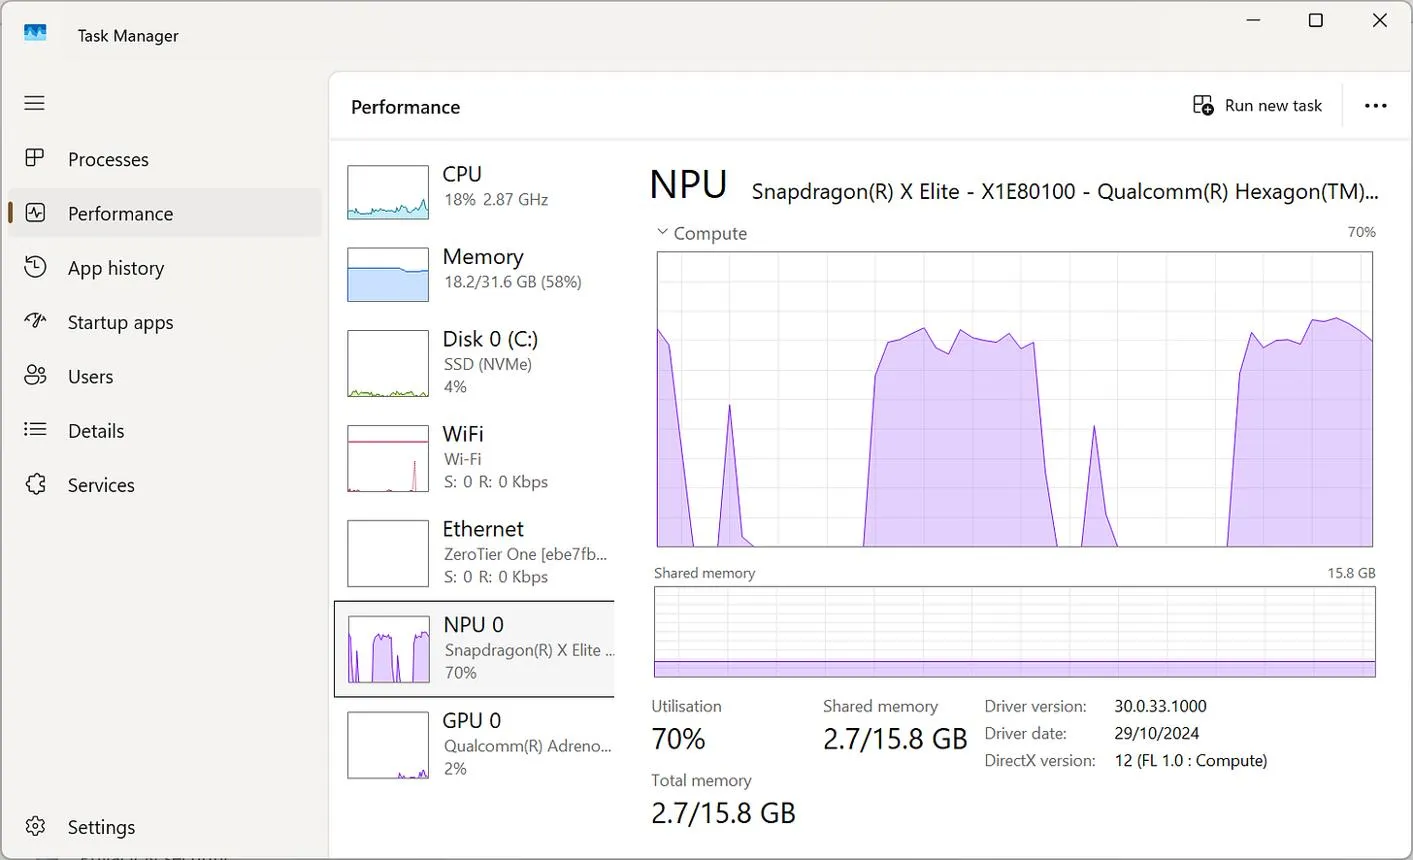
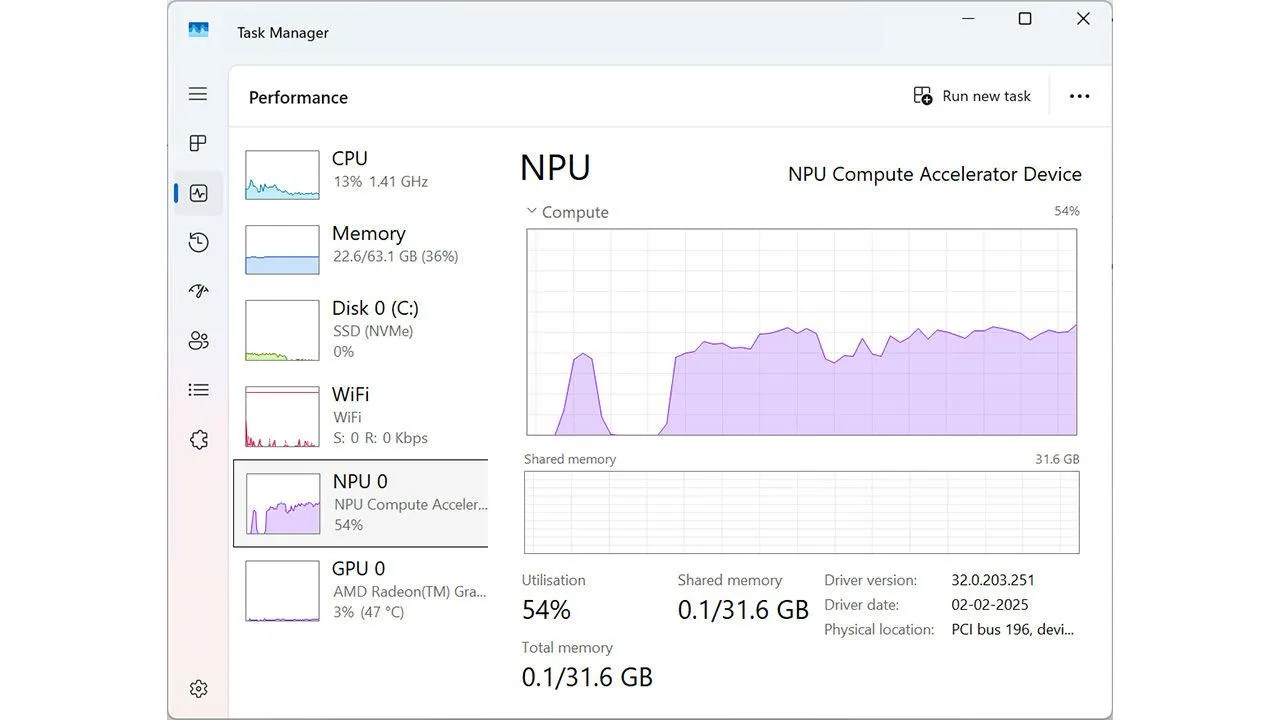
در ویندوز میتوانید وضعیت NPU را از طریق تاسک منیجر بررسی کنید. این بخش اطلاعاتی درباره میزان استفاده از واحد پردازش عصبی نمایش میدهد؛ با این حال، عدد نمایشدادهشده همیشه معیار کاملی برای سنجش فعالیت یا مصرف انرژی واقعی نیست.
برای مشاهده اطلاعات NPU وارد تاسک منیجر شوید و بخش عملکرد را باز کنید.
Task Manager → Performance → NPU
تاسک منیجر ← عملکرد ← NPU
اگر دستگاه شما NPU سازگار داشته باشد و درایور آن بهدرستی نصب شده باشد، ممکن است نمودار استفاده از NPU را در این بخش مشاهده کنید. در برخی سیستمها، نام یا تعداد موتورهای پردازشی نیز نمایش داده میشود.
نکته مهم این است که گاهی ابزارهای نظارتی ویندوز میزان استفاده از NPU را دقیق گزارش نمیکنند. بنابراین اگر یک برنامه اعلام میکند مدل روی NPU اجرا شده، اما تاسک منیجر استفاده صفر درصدی نشان میدهد، بهتر است گزارش نرمافزار و ابزارهای تخصصی سازنده را نیز بررسی کنید.
جمعبندی؛ NPU برای چه کسانی ارزش استفاده دارد؟
NPU قرار نیست در تمام پردازشهای هوش مصنوعی جایگزین CPU و GPU شود. این واحد سختافزاری بیشتر برای اجرای وظایف مشخص با مصرف انرژی پایین طراحی شده است و کاربرد آن به سازگاری مدل و نرمافزار بستگی دارد.
اگر از لپتاپ مجهز به AMD Ryzen AI استفاده میکنید، ابزارهایی مانند Lemonade و FastFlowLM امکان اجرای مدلهای محلی روی NPU را فراهم میکنند. این قابلیت برای تبدیل گفتار به متن، برخی پردازشهای پسزمینه و اجرای مدلهای سازگار مفید است.
در مقابل، اگر اولویت شما تولید سریع پاسخ در چتباتها یا اجرای مدلهای زبانی بزرگ است، ممکن است GPU مجتمع یا مجزا عملکرد بهتری ارائه کند. بنابراین هنگام انتخاب لپتاپ هوش مصنوعی، فقط به وجود NPU یا عدد TOPS آن توجه نکنید؛ سازگاری نرمافزارها، سرعت واقعی مدلها و مصرف انرژی کل سیستم نیز اهمیت دارند.
اینتوتک