اجرای مدلهای هوش مصنوعی روی لپتاپ شخصی دیگر فقط به داشتن یک پردازنده گرافیکی قدرتمند وابسته نیست. ظرفیت حافظه، پهنای باند رم و سازگاری نرمافزار با سختافزار هم میتوانند تعیین کنند که یک مدل زبانی اصلاً اجرا شود یا نه. مقایسه لپتاپ HP OmniBook Ultra 16 مجهز به پلتفرم NVIDIA RTX Spark با ASUS Zenbook A16 دارای پردازنده Snapdragon X2 Elite Extreme نشان میدهد که در بعضی کاربردهای هوش مصنوعی، حافظه بیشتر حتی از قدرت گرافیکی بالاتر هم مهمتر است.
اجرای هوش مصنوعی محلی؛ چرا انتخاب لپتاپ اهمیت دارد؟
اجرای محلی هوش مصنوعی به این معناست که مدل زبانی روی سختافزار خودتان اجرا شود و برای پردازش هر درخواست به سرورهای ابری وابسته نباشید. این روش میتواند حریم خصوصی بیشتری فراهم کند و وابستگی به اشتراک یا محدودیت سرویسهای آنلاین را کاهش دهد؛ البته به شرطی که سختافزار توان اجرای مدل موردنظر را داشته باشد.
در این روش، فقط سرعت پردازنده یا تعداد هستههای گرافیکی اهمیت ندارد. مدلهای بزرگ به حافظه زیادی نیاز دارند و علاوه بر فایل اصلی مدل، فضای لازم برای پردازش متن، حافظه زمینه و دادههای موقت نیز باید در نظر گرفته شود. به همین دلیل ممکن است یک لپتاپ با پردازنده گرافیکی قدرتمند، به دلیل ظرفیت حافظه محدود نتواند مدل موردنظر را اجرا کند.
نقش حافظه رم در اجرای مدلهای زبانی
حافظه رم یکی از مهمترین عوامل در اجرای مدل زبانی است. هرچه تعداد پارامترهای مدل بیشتر باشد، معمولاً برای بارگذاری وزنهای آن به حافظه بیشتری نیاز خواهید داشت. البته حجم نهایی به روش فشردهسازی یا Quantization نیز بستگی دارد؛ نسخههای ۴ بیتی معمولاً حافظه کمتری از نسخههای دقیقتر اشغال میکنند، اما ممکن است بخشی از کیفیت خروجی را از دست بدهند.
نکته مهم این است که تمام حافظه دستگاه در اختیار مدل قرار نمیگیرد. سیستمعامل، نرمافزار اجراکننده، حافظه زمینه و سایر پردازشها نیز بخشی از ظرفیت را مصرف میکنند. بنابراین داشتن ۳۲ گیگابایت رم الزاماً به معنای امکان بارگذاری یک مدل با حجم ۳۲ گیگابایت نیست.
Hermes Agent و LM Studio چه نقشی دارند؟
Hermes Agent یک عامل هوش مصنوعی است که میتواند علاوه بر پاسخگویی، کارهایی مانند نوشتن کد، اجرای فرمانها و کار با ابزارها را انجام دهد. این نرمافزار میتواند از مدلهای محلی استفاده کند؛ اما برای عملکرد مناسب، مدل انتخابشده باید با ظرفیت حافظه و توان پردازشی دستگاه سازگار باشد.
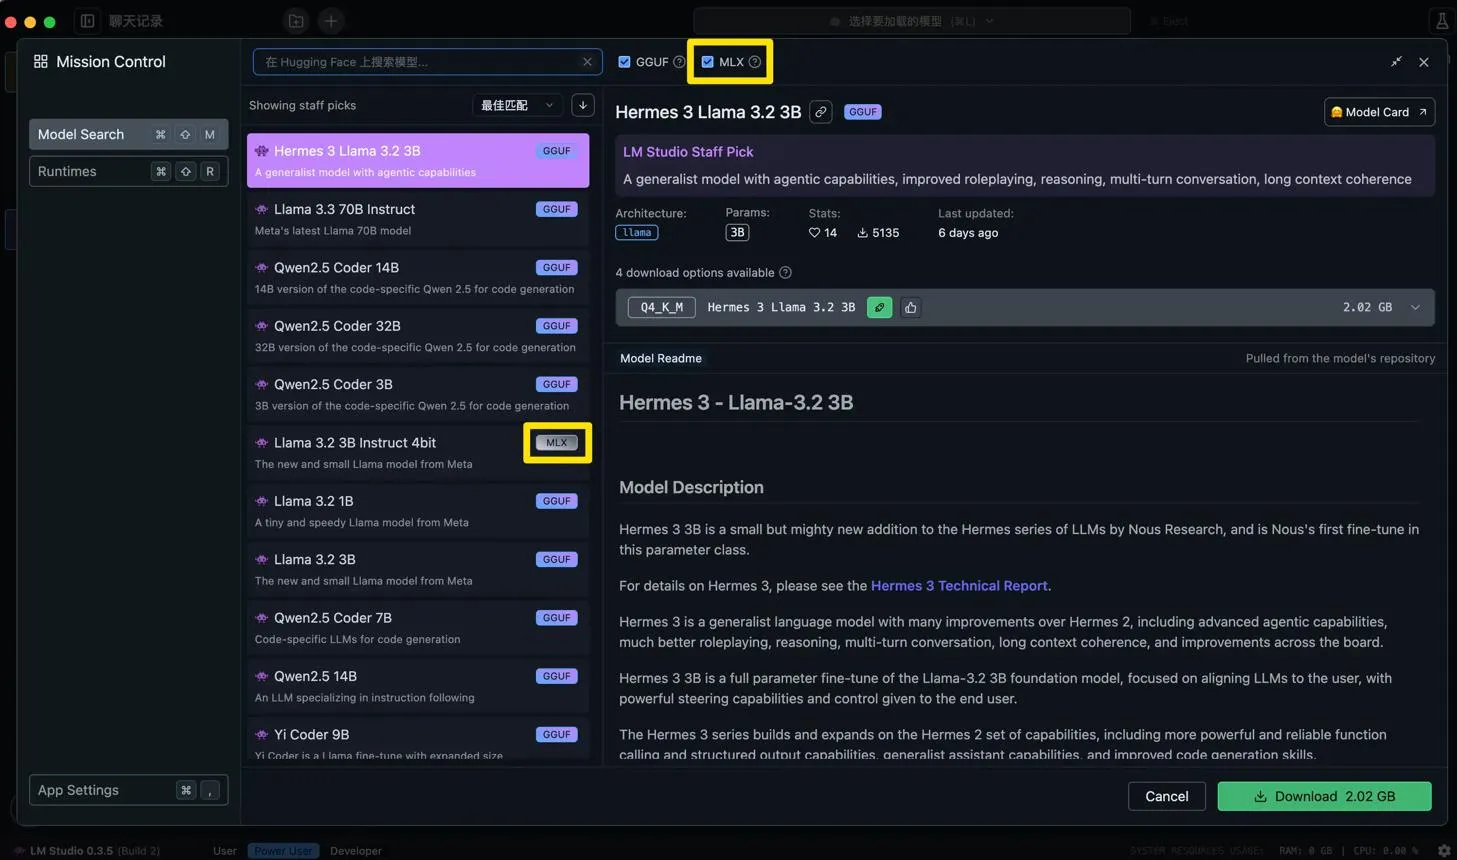
LM Studio نیز ابزاری برای دانلود، مدیریت و اجرای مدلهای زبانی روی کامپیوتر است. میتوان مدل را در این نرمافزار اجرا کرد و از طریق سرور محلی در اختیار برنامههای دیگر قرار داد. در نتیجه، ترکیب Hermes Agent و LM Studio امکان ساخت یک دستیار هوش مصنوعی محلی را فراهم میکند.
مقایسه HP OmniBook Ultra 16 و ASUS Zenbook A16 برای هوش مصنوعی
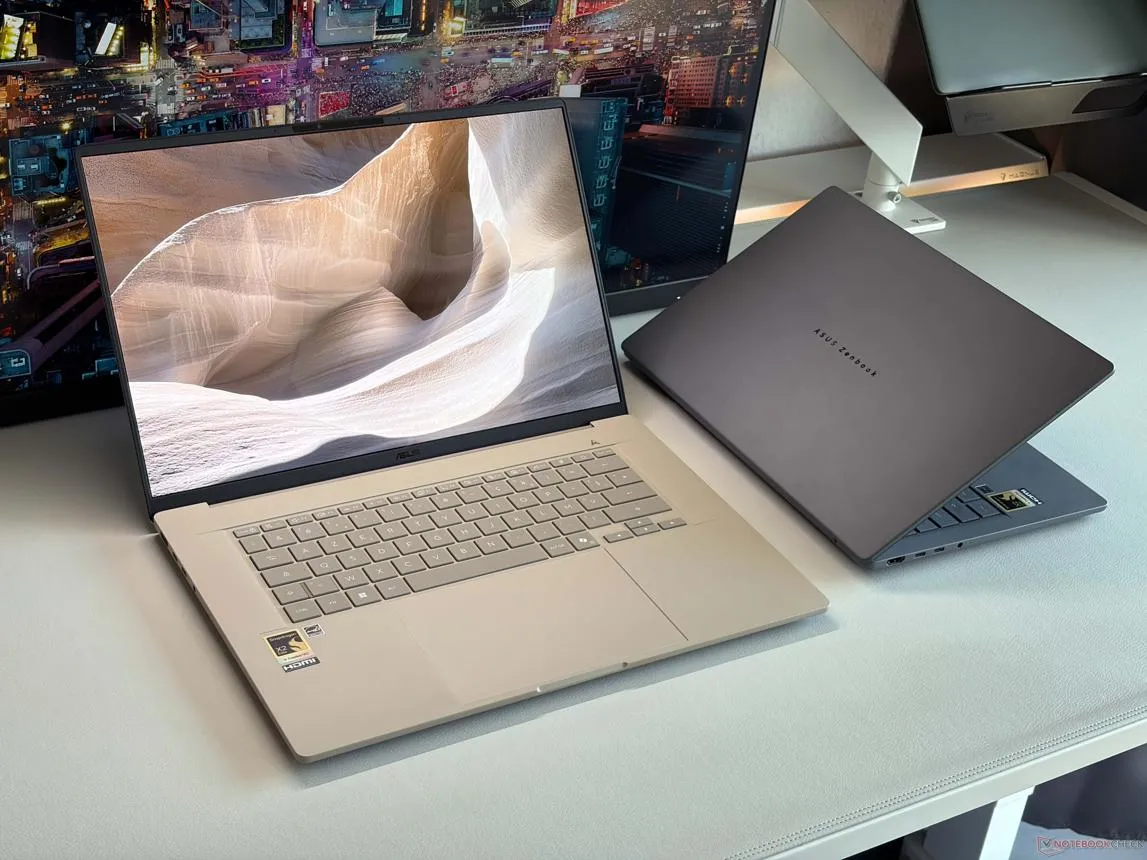
در این مقایسه، HP OmniBook Ultra 16 با پلتفرم NVIDIA RTX Spark و ۳۲ گیگابایت حافظه در برابر ASUS Zenbook A16 با پردازنده Snapdragon X2 Elite Extreme و ۴۸ گیگابایت حافظه قرار میگیرد.
مشخصات این دو دستگاه نشان میدهد که طراحی سختافزاری آنها متفاوت است. HP روی توان پردازش گرافیکی و معماری NVIDIA تمرکز دارد، در حالی که ایسوس از پردازنده یکپارچه کوالکام با حافظه مشترک استفاده میکند.
مشخصات سختافزاری HP OmniBook Ultra 16
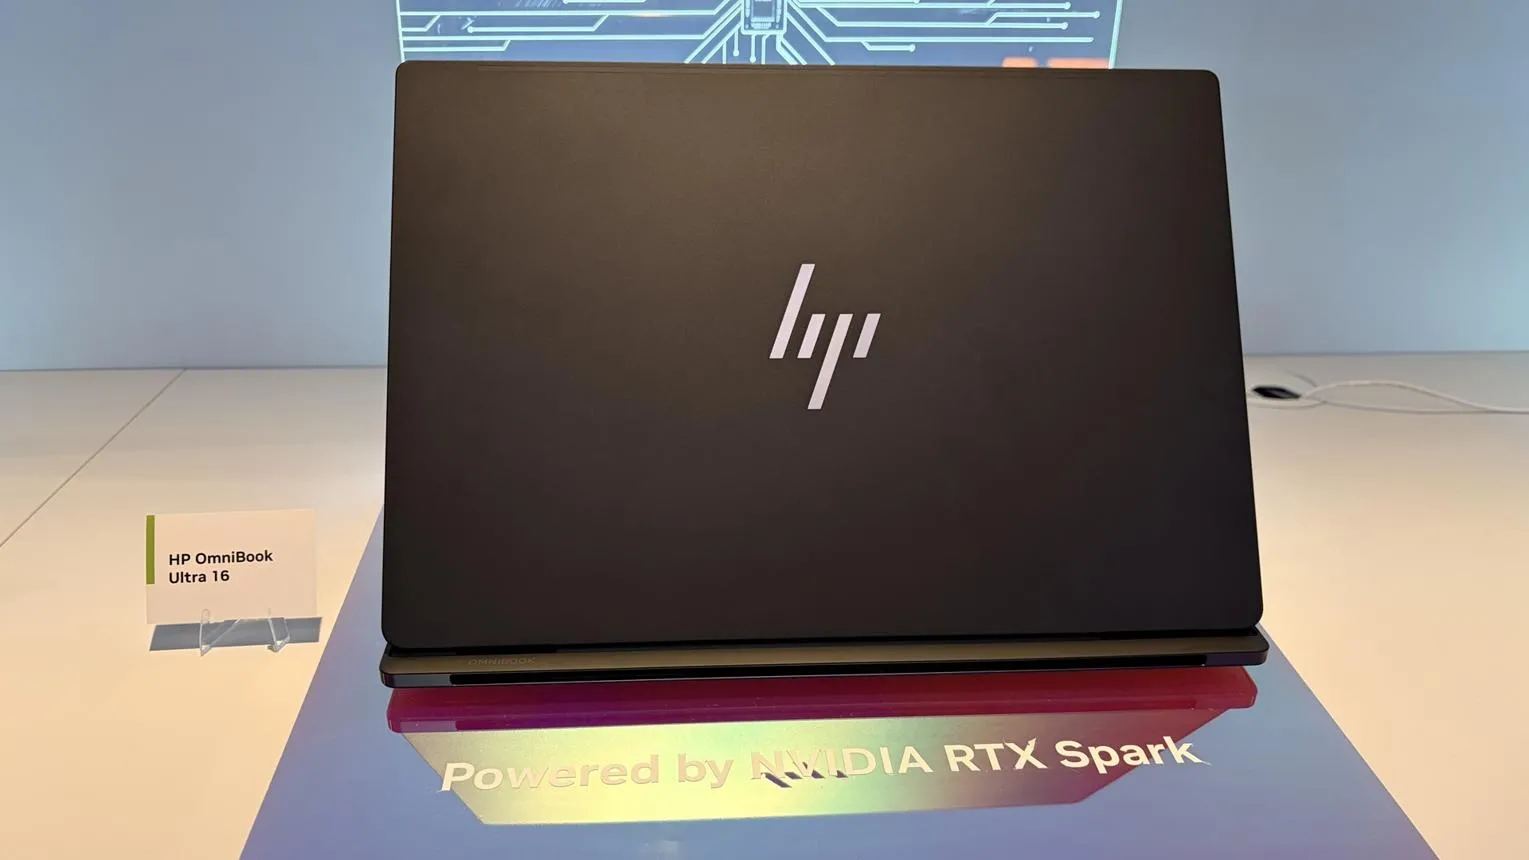
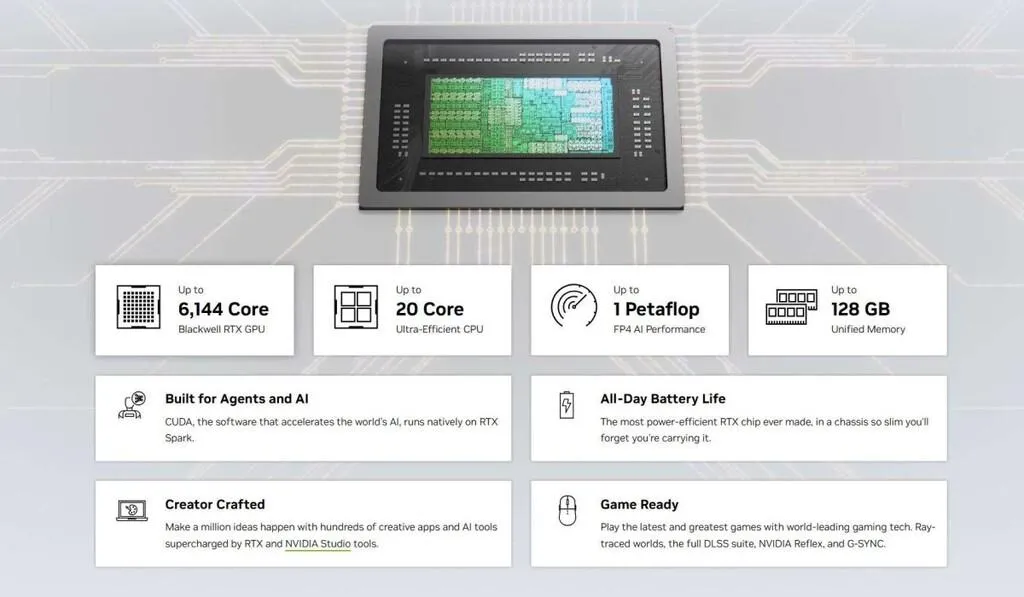
مدل HP OmniBook Ultra 16 از پلتفرم RTX Spark N1X استفاده میکند که پردازنده مرکزی مبتنی بر معماری Arm و پردازنده گرافیکی Blackwell انویدیا را در یک سیستم یکپارچه قرار میدهد. نسخه مورد بررسی دارای ۳۲ گیگابایت حافظه LPDDR5X با سرعت ۹۴۰۰ MT/s و یک ترابایت حافظه SSD است.
نقطه قوت این دستگاه، توان پردازش گرافیکی و پشتیبانی از فناوریهای نرمافزاری انویدیا است. در صورت سازگاری مدل با حافظه موجود، پردازشهای مبتنی بر GPU و فناوری CUDA میتوانند سرعت بالایی داشته باشند. مشکل زمانی ایجاد میشود که مدل به حافظه بیشتری از ظرفیت قابلاستفاده دستگاه نیاز داشته باشد.
مشخصات سختافزاری ASUS Zenbook A16
ASUS Zenbook A16 از پردازنده ۱۸ هستهای Snapdragon X2 Elite Extreme و گرافیک یکپارچه Qualcomm Adreno استفاده میکند. نسخه مورد مقایسه ۴۸ گیگابایت حافظه LPDDR5X و یک ترابایت فضای ذخیرهسازی دارد. نمایشگر ۱۶ اینچی OLED با وضوح 3K و نرخ نوسازی ۱۲۰ هرتز نیز از ویژگیهای مهم این مدل است.
مزیت اصلی این لپتاپ در آزمایش اجرای مدلهای محلی، ظرفیت حافظه بیشتر آن بود. حافظه مشترک دستگاه در اختیار پردازنده مرکزی و گرافیک قرار میگیرد و همین موضوع میتواند امکان بارگذاری مدلهای بزرگتری را فراهم کند؛ هرچند اجرای مدل روی CPU بهجای GPU معمولاً سرعت پایینتری دارد.
آزمایش Hermes Agent؛ کدام لپتاپ مدلهای بیشتری اجرا میکند؟
در آزمایش عملی، Hermes Agent روی هر دو لپتاپ اجرا شد تا مشخص شود کدام دستگاه میتواند مدلهای زبانی بزرگ را بدون تنظیمات پیچیده بارگذاری کند. نتیجه برخلاف انتظار بود: نسخه ۳۲ گیگابایتی HP در فهرست مدلهای پیشنهادی Hermes گزینه سازگاری نشان نمیداد، اما Zenbook با حافظه ۴۸ گیگابایتی امکان نصب چند مدل را فراهم کرد.
البته این نتیجه به معنی برتری همیشگی پردازنده کوالکام نیست. ظرفیت حافظه، نسخه مدل، فشردهسازی و نحوه تخصیص منابع در این آزمایش نقش مهمی داشتند.
چرا HP با وجود گرافیک قدرتمند در بارگذاری مدلها مشکل داشت؟
در آزمایش انجامشده، Hermes Agent روی نسخه ۳۲ گیگابایتی HP OmniBook Ultra 16 هیچکدام از مدلهای پیشنهادی موردنظر را بهصورت مستقیم سازگار تشخیص نداد؛ حتی با اختصاص ۱۶ گیگابایت حافظه به بخش گرافیکی.
با استفاده از LM Studio امکان اجرای مدل Qwen 3.6 35B-A3B با فشردهسازی IQ4XS فراهم شد، اما برای رسیدن به نتیجه قابلقبول به تنظیمات متعدد نیاز بود. همچنین در بعضی اجراها، محدودیت حافظه زمینه باعث توقف یا کرش برنامه میشد.
این تجربه نشان میدهد که قدرت پردازنده گرافیکی بهتنهایی تضمینکننده اجرای مدلهای بزرگ نیست. اگر فضای کافی برای وزنهای مدل و حافظه موردنیاز پردازش وجود نداشته باشد، حتی یک سیستم مجهز به GPU قدرتمند هم ممکن است در بارگذاری مدل با مشکل روبهرو شود.
چرا Zenbook A16 مدلهای بزرگتر را بارگذاری کرد؟
در Zenbook A16، نرمافزار Hermes امکان نصب مدلهایی مانند Qwen 3.8 27B و Nemotron 3.5 Bolt را بدون تنظیمات پیچیده فراهم کرد. مدل Qwen 3.6 35B-A3B نیز در این دستگاه اجرا شد و در آزمایشهای انجامشده، اجرای درخواستها بدون کرش ادامه پیدا کرد.
با این حال، گرافیک Adreno در این آزمایش با خطاهای درایور روبهرو شد و مدل بهجای GPU روی پردازنده مرکزی اجرا شد. بنابراین پاسخگویی به درخواستها چند دقیقه طول میکشید. این سرعت برای استفاده روزمره چندان مطلوب نیست، اما دستگاه دستکم توانست مدل را بارگذاری کند و پاسخ ارائه دهد.
سرعت اجرای مدل و برنامهنویسی؛ برنده واقعی کدام است؟
بارگذاری موفق یک مدل به معنی اجرای سریع آن نیست. در آزمایشهای انجامشده، Zenbook A16 توانست درخواستهایی را پردازش کند که در HP به دلیل محدودیت حافظه یا خطاهای اجرایی متوقف میشدند؛ اما زمان پاسخگویی در Zenbook بیشتر بود.
از سوی دیگر، زمانی که مدل روی سختافزار NVIDIA بهدرستی اجرا میشد، توان پردازش گرافیکی و پشتیبانی از CUDA مزیت مهمی برای HP ایجاد میکرد. بنابراین باید بین دو موضوع تفاوت قائل شد: توانایی بارگذاری مدل و سرعت اجرای آن.
آزمایش نوشتن کد پایتون با Hermes Agent
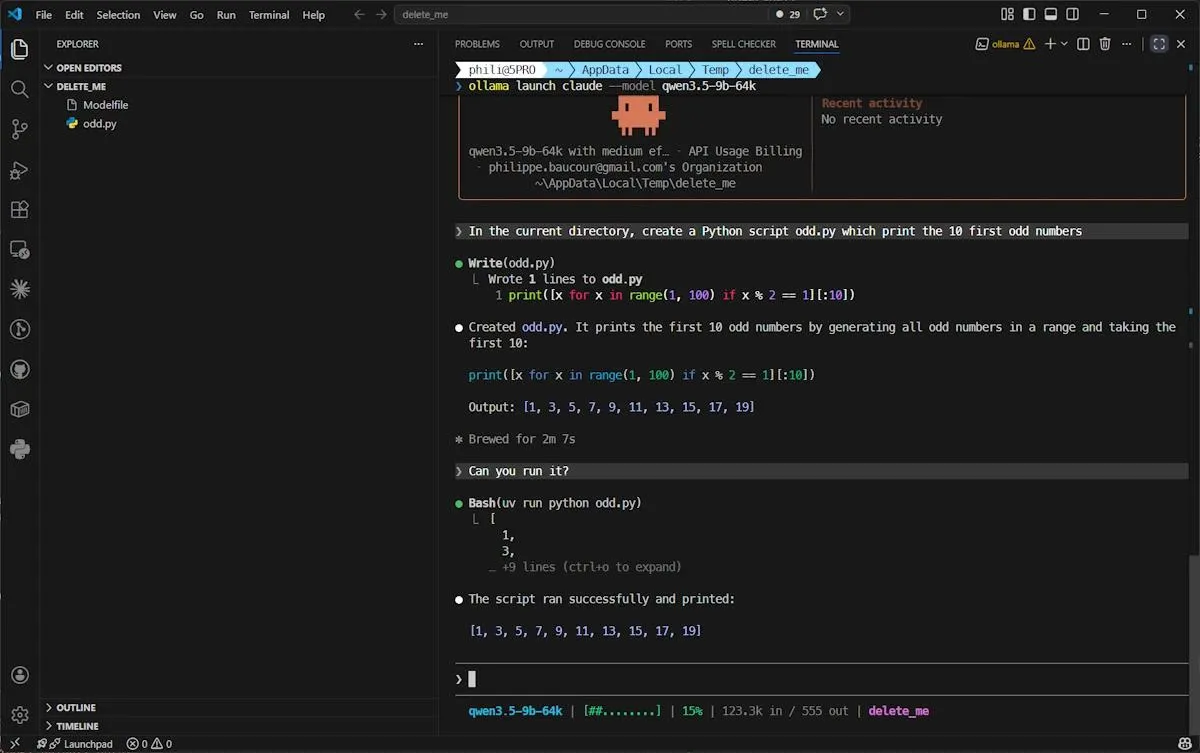
برای بررسی توانایی برنامهنویسی، از Hermes Agent خواسته شد یک اسکریپت ساده پایتون بنویسد، آن را با ابزار pytest آزمایش کند و در صورت وجود خطا، کد را اصلاح کند.
در HP اجرای این درخواست با خطا و توقف مدل همراه شد. در Zenbook فرایند ساخت اسکریپت شروع شد و مدل توانست روی کد کار کند؛ اما پس از حدود یک ساعت هنوز آزمایش کامل نشده بود.
این نتیجه نشان میدهد Zenbook برای اجرای چنین وظایفی ظرفیت بیشتری در اختیار داشت، ولی سرعت پردازش آن برای کارهای طولانی و پیچیده کافی نبود. در مقابل، HP در صورت قرار گرفتن مدل در محدوده حافظه قابلاستفاده، میتوانست عملکرد سریعتری ارائه کند.
مزیت CUDA در اجرای هوش مصنوعی محلی
فناوری CUDA یکی از مهمترین مزایای سیستمهای مجهز به پردازنده گرافیکی NVIDIA است. بسیاری از ابزارها و چارچوبهای هوش مصنوعی از CUDA برای اجرای محاسبات سنگین روی GPU استفاده میکنند. به همین دلیل، اگر مدل موردنظر با سختافزار و نرمافزار دستگاه سازگار باشد و حافظه کافی در اختیار داشته باشد، سیستم NVIDIA میتواند بسیار سریعتر از اجرای همان مدل روی CPU عمل کند.
در واقع، مشکل آزمایش HP را نباید به ضعف کلی RTX Spark نسبت داد. محدودیت اصلی نسخه ۳۲ گیگابایتی، فضای حافظه قابلاستفاده برای مدلهای بزرگ بود. نسخههایی با حافظه ۶۴ یا ۱۲۸ گیگابایتی میتوانند شرایط متفاوتی داشته باشند؛ البته عملکرد واقعی به مدل و نرمافزار مورد استفاده نیز وابسته است.
برای اجرای مدلهای هوش مصنوعی محلی کدام لپتاپ را بخریم؟
اگر انتخاب فقط بین نسخه ۳۲ گیگابایتی HP OmniBook Ultra 16 و نسخه ۴۸ گیگابایتی ASUS Zenbook A16 باشد، Zenbook در آزمایش مورد بحث انتخاب کاربردیتری برای بارگذاری مدلهای بزرگ بود. این دستگاه توانست مدلهایی را اجرا کند که HP با تنظیمات پیشفرض Hermes قادر به بارگذاری آنها نبود.
اما اگر اولویت شما سرعت پردازش GPU، اجرای مدلهای سازگار با CUDA و انجام وظایف سنگین هوش مصنوعی باشد، سیستم NVIDIA با ظرفیت حافظه بیشتر میتواند انتخاب قدرتمندتری باشد. به همین دلیل، مقایسه این دو لپتاپ صرفاً بر اساس نام پردازنده یا تعداد هستههای گرافیکی نتیجه دقیقی به همراه ندارد.
هنگام خرید لپتاپ برای اجرای هوش مصنوعی به چه نکاتی توجه کنیم؟
- ظرفیت حافظه: برای مدلهای بزرگ، ظرفیت رم و حافظه یکپارچه اهمیت زیادی دارد. پیش از خرید، حجم مدلهای موردنظرتان را بررسی کنید.
- سازگاری نرمافزار: مطمئن شوید ابزارهایی مانند Hermes Agent و LM Studio از پردازنده و شتابدهنده گرافیکی دستگاه پشتیبانی میکنند.
- پشتیبانی از CUDA: اگر قصد اجرای مدلهای مبتنی بر NVIDIA را دارید، سازگاری CUDA و درایورهای مربوط به آن را بررسی کنید.
- سرعت حافظه: پهنای باند حافظه در سرعت پردازش مدلهای زبانی مؤثر است و فقط ظرفیت رم اهمیت ندارد.
- نوع استفاده: برای پاسخگویی روزمره، اجرای مدلهای سبک و کارهای ساده، یک لپتاپ با حافظه بیشتر ممکن است کافی باشد؛ اما برنامهنویسی و پردازشهای عاملمحور پیچیده به منابع بیشتری نیاز دارند.
در نهایت، برای اجرای هوش مصنوعی محلی باید ظرفیت حافظه را در کنار قدرت پردازنده و سازگاری نرمافزار در نظر بگیرید. Zenbook A16 در این مقایسه به دلیل حافظه بیشتر توانست مدلهای بزرگتری را اجرا کند، اما این موضوع به معنی سریعتر بودن آن در تمام پردازشها نیست. اگر به دنبال اجرای سریع مدلهای بزرگ هستید، بهتر است بهجای انتخاب نسخه ۳۲ گیگابایتی، سراغ سیستمی با حافظه بیشتر و پشتیبانی نرمافزاری مناسب بروید.
اینتوتک