اجرای مدلهای زبانی بزرگ روی کامپیوتر شخصی دیگر صرفاً به مدلهای کوچک و کارتهای گرافیک گرانقیمت محدود نیست. با استفاده از تکنیکهایی مانند کوانتایزیشن و تقسیم پردازش بین حافظه گرافیکی و RAM میتوان بعضی مدلهای بسیار بزرگ را روی سختافزار ضعیفتر نیز اجرا کرد؛ البته اجرای مدل با سرعت مناسب و بدون خطا، مسئلهای جداگانه است.
یکی از نمونههای جالب این رویکرد، اجرای مدل Nemotron 3.5 Bolt 74B-A9B متعلق به NVIDIA با کمک llama.cpp و اتصال آن به Hermes Agent است. این ترکیب میتواند یک کامپیوتر شخصی را به دستیار هوش مصنوعی محلی تبدیل کند که علاوه بر پاسخگویی، توانایی استفاده از مرورگر، ترمینال و فایلها و انجام وظایف چندمرحلهای را نیز دارد.
مدل Nemotron 3.5 Bolt 74B چیست و چرا اجرای آن اهمیت دارد؟
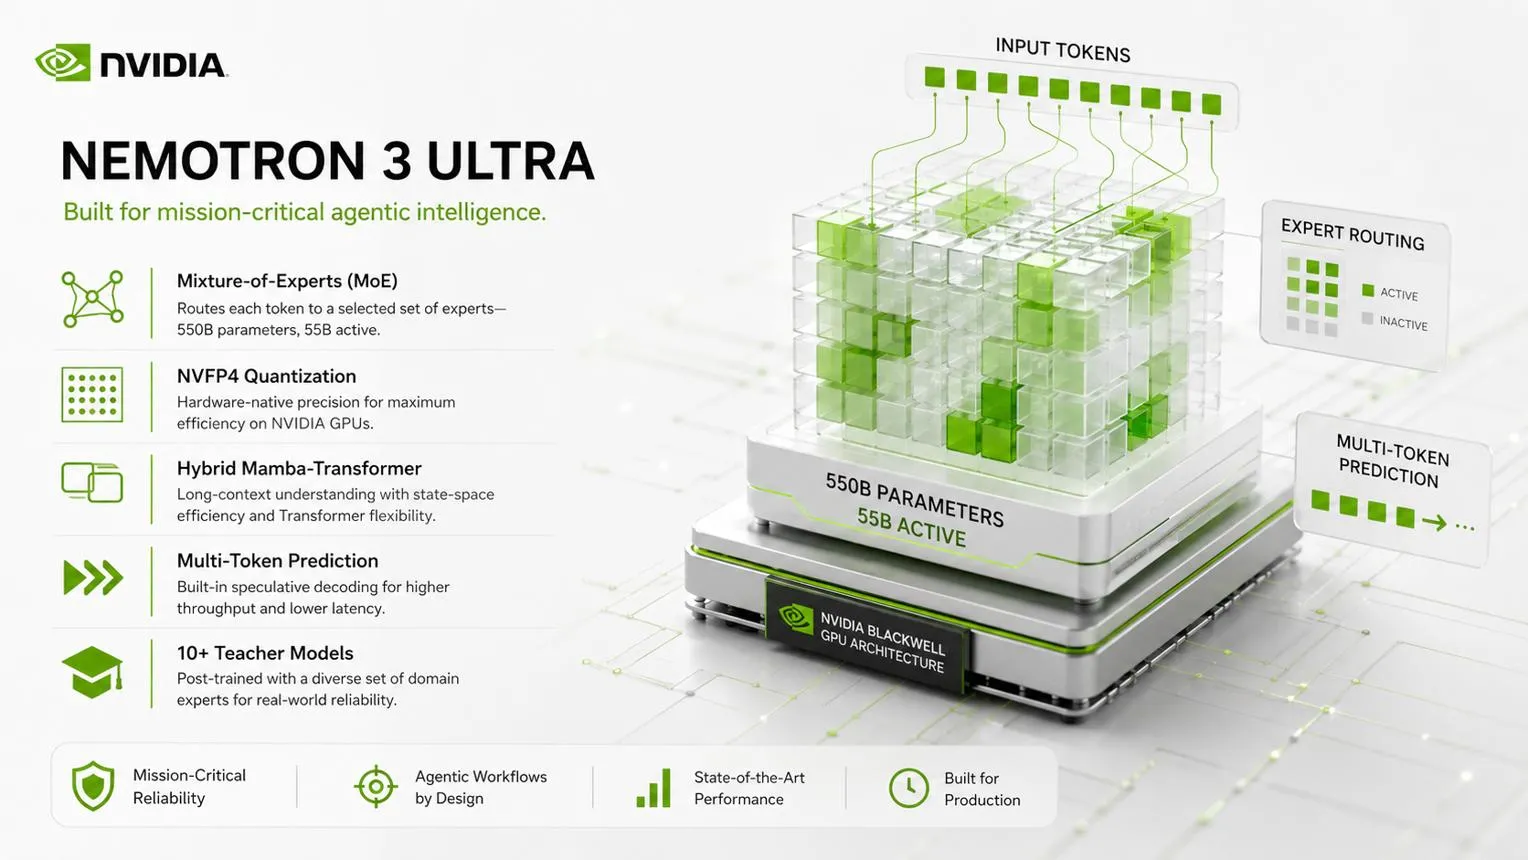
Nemotron 3.5 Bolt 74B-A9B مدل زبانی با معماری ترکیبی و ۷۴ میلیارد پارامتر
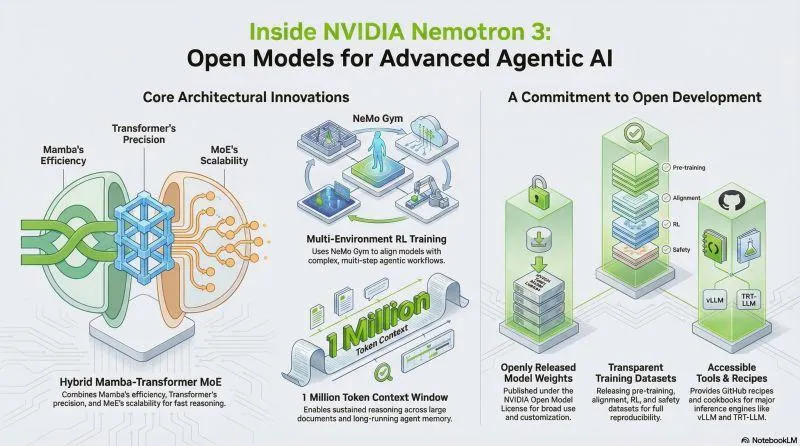
Nemotron 3.5 Bolt یک مدل زبانی از خانواده Nemotron انویدیا است که با معماری ترکیبی Mamba و Transformer و ساختار Mixture of Experts طراحی شده است. این مدل در مجموع ۷۴ میلیارد پارامتر دارد، اما در هر مرحله از تولید پاسخ حدود ۹ میلیارد پارامتر فعال هستند. بنابراین نباید تصور کرد که اجرای آن از نظر محاسباتی دقیقاً مشابه یک مدل متراکم ۷۴ میلیارد پارامتری است.
یکی از ویژگیهای مهم آن، استفاده از کوانتایزیشن بسیار فشرده است. وزن بخش بزرگی از مدل با قالب IQ2_XXS و دقت حدود ۲ بیت ذخیره شده است. بخشهایی از معماری نیز از قالبهای NVFP4 و Q8_0 استفاده میکنند. این روش حجم مدل را به میزان قابلتوجهی کاهش میدهد، بدون اینکه لازم باشد تمام وزنها با دقت بالای FP16 نگهداری شوند.
این مدل علاوه بر متن، از ورودی تصویری و ویدیویی نیز پشتیبانی میکند و برای اجرای وظایف عاملمحور یا Agentic طراحی شده است؛ یعنی میتواند با استفاده از ابزارهای متصل به خود، کارهایی فراتر از تولید متن انجام دهد.
تفاوت ۷۴ میلیارد پارامتر با ۹ میلیارد پارامتر فعال چیست؟
در مدلهای Mixture of Experts همه بخشهای شبکه برای پردازش هر توکن به یک اندازه فعال نمیشوند. مدل از چندین مجموعه متخصص تشکیل شده و سازوکار مسیریابی، متخصصان موردنیاز را برای هر ورودی انتخاب میکند.
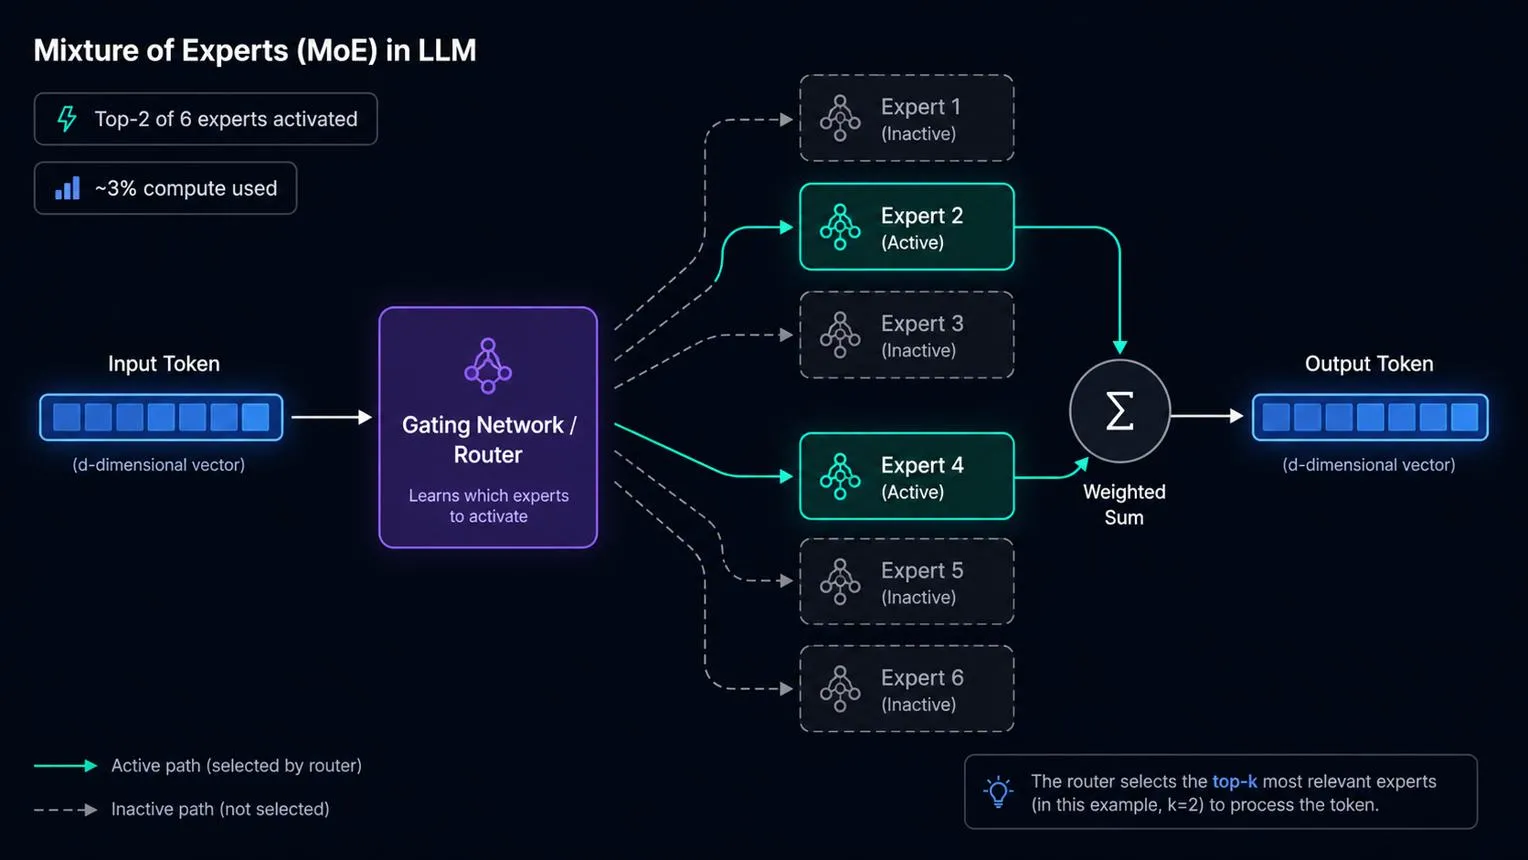
در نتیجه، Nemotron 3.5 Bolt با وجود داشتن ۷۴ میلیارد پارامتر کلی، در هر مرحله از پردازش از حدود ۹ میلیارد پارامتر فعال استفاده میکند. این طراحی میتواند هزینه محاسباتی را کاهش دهد؛ اما به این معنا نیست که کل مدل فقط به حافظهای معادل یک مدل ۹ میلیارد پارامتری نیاز دارد. وزن تمام متخصصان همچنان باید در حافظه گرافیکی یا RAM نگهداری شود.
اجرای Nemotron 3.5 Bolt روی کارت گرافیک ۱۶ گیگابایتی با llama.cpp
نکته جالب در آزمایش انجامشده، اجرای مدل روی RTX 4070 Ti Super با ۱۶ گیگابایت حافظه گرافیکی و ۳۲ گیگابایت RAM بود. فایل مدل بهتنهایی حدود ۲۴ گیگابایت حجم داشت و طبیعتاً نمیتوانست بهطور کامل در VRAM این کارت جا بگیرد.
برای حل این مشکل از llama.cpp استفاده شد. این نرمافزار امکان اجرای مدلهای GGUF و تقسیم بار حافظه بین GPU و پردازنده را فراهم میکند. به این ترتیب بخشی از وزنهای مدل روی کارت گرافیک قرار میگیرد و بخش باقیمانده از حافظه سیستم استفاده میکند.
در آزمایش مورد بحث، با استفاده از گزینه --fit حافظه قابل استفاده کارت گرافیک بهصورت خودکار شناسایی شد. در نهایت حدود ۱۵٫۷ گیگابایت از حافظه گرافیکی اشغال شد و باقی اطلاعات مدل در RAM قرار گرفت. نتیجه این بود که مدل با سرعت گزارششده حدود ۲۲ تا ۳۲ توکن بر ثانیه اجرا شد؛ در حالی که اجرای مدل با تمام لایههای متخصص روی CPU سرعتی در حدود ۱۹ توکن بر ثانیه داشت.
این اعداد نتیجه یک آزمایش مشخص هستند و نباید آنها را سرعت تضمینشده برای تمام سیستمها در نظر گرفت. نوع پردازنده، سرعت RAM، نسخه llama.cpp، اندازه Context و تنظیمات پردازش میتوانند نتیجه را تغییر دهند.
چرا حافظه RAM در اجرای مدلهای بزرگ اهمیت دارد؟
حافظه VRAM کارت گرافیک تنها عامل تعیینکننده برای اجرای مدلهای هوش مصنوعی نیست. اگر مدل بزرگتر از ظرفیت VRAM باشد، بعضی از وزنها میتوانند در حافظه اصلی سیستم قرار بگیرند و هنگام پردازش به GPU منتقل شوند.
این روش امکان اجرای مدلهای بزرگتر را فراهم میکند، اما معمولاً سرعت آن از حالتی که تمام وزنهای موردنیاز روی GPU قرار دارند پایینتر است. علت اصلی این مسئله تفاوت پهنای باند حافظه RAM با حافظه گرافیکی است.
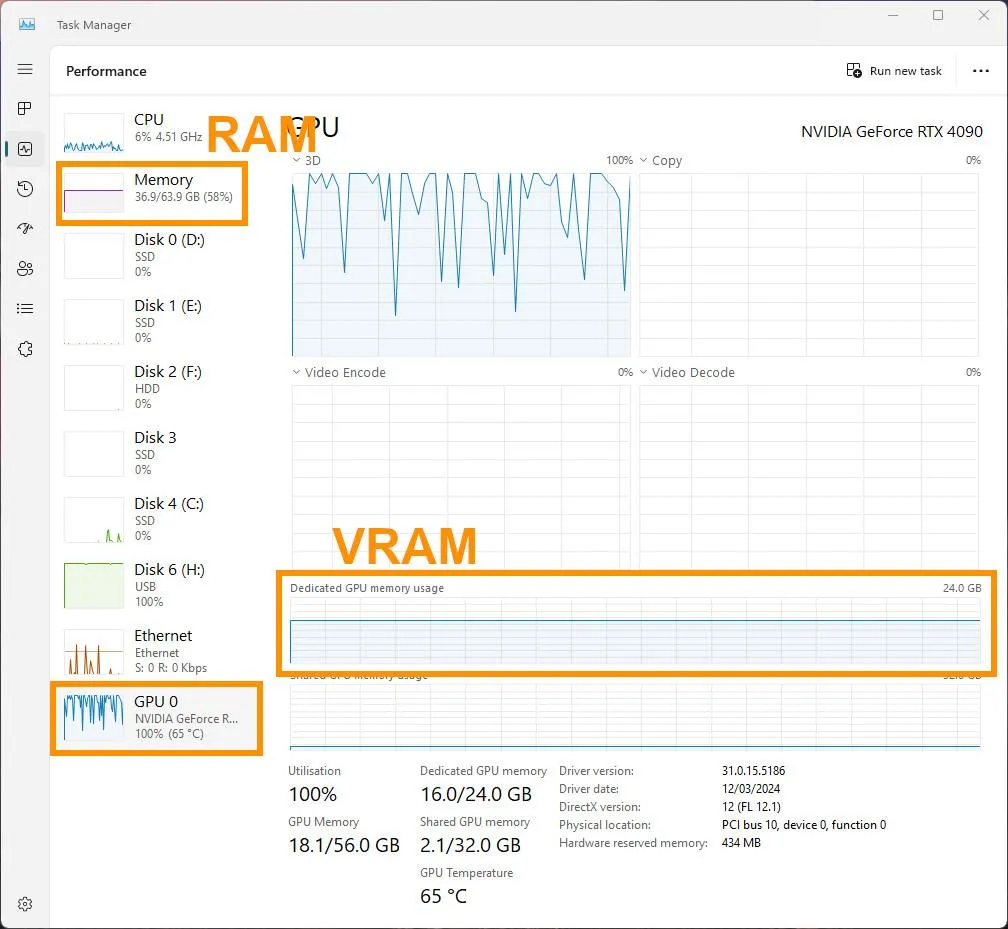
در اجرای مدل Nemotron 3.5 Bolt باید چند عامل را در نظر گرفت:
- ظرفیت VRAM: هرچه بخش بیشتری از مدل در حافظه گرافیکی جا بگیرد، نیاز به انتقال اطلاعات بین RAM و GPU کمتر میشود.
- ظرفیت RAM: حافظه اصلی باید فضای کافی برای وزنهای باقیمانده مدل و سایر بخشهای سیستم داشته باشد.
- پهنای باند حافظه: سرعت انتقال داده بین پردازنده و کارت گرافیک روی سرعت تولید توکن اثر میگذارد.
- اندازه Context: هرچه متن ورودی و تاریخچه مکالمه طولانیتر باشد، حافظه بیشتری برای پردازش و KV Cache نیاز است.
نکته مهم این است که نسخه رسمی ۲۴ گیگابایتی Nemotron برای سختافزارهایی با حافظه بیشتر طراحی شده است. راهنماهای رسمی NVIDIA برای پیکربندیهای این مدل، کارتهای گرافیک با ۳۲ گیگابایت و بالاتر را برای برخی تنظیمات معرفی میکنند. بنابراین اجرای آن روی کارت ۱۶ گیگابایتی را باید یک آزمایش با تقسیم حافظه دانست، نه پیکربندی پیشنهادی و تضمینشده سازنده.
تبدیل مدل محلی به دستیار هوش مصنوعی با Hermes Agent
اجرای مدل در llama.cpp بهتنهایی یک دستیار خودکار ایجاد نمیکند. این نرمافزار وظیفه بارگذاری مدل و تولید پاسخ را بر عهده دارد؛ اما برای اینکه مدل بتواند به مرورگر دسترسی پیدا کند، فایلها را بخواند یا فرمانهای ترمینال را اجرا کند، به یک چارچوب عاملمحور نیاز است.
در این آزمایش از Hermes Agent استفاده شده است. این ابزار میتواند به یک مدل محلی از طریق رابط سازگار با OpenAI متصل شود و امکاناتی مانند اجرای فرمان، دسترسی به فایلها، مرور وب، حافظه و مهارتهای قابل استفاده مجدد را در اختیار آن قرار دهد.
برای اتصال، ابتدا باید llama.cpp به شکل یک سرور اجرا شود. سپس در تنظیمات Hermes Agent، گزینه Custom Endpoint انتخاب و نشانی سرور محلی به همراه نام مدل وارد میشود. در چنین حالتی برای ارتباط با مدل محلی نیازی به کلید API سرویسهای ابری نیست؛ البته این موضوع به معنی آفلاین بودن تمام قابلیتهای عامل نیست، زیرا جستوجوی وب و بعضی ابزارهای بیرونی همچنان ممکن است به اینترنت نیاز داشته باشند.
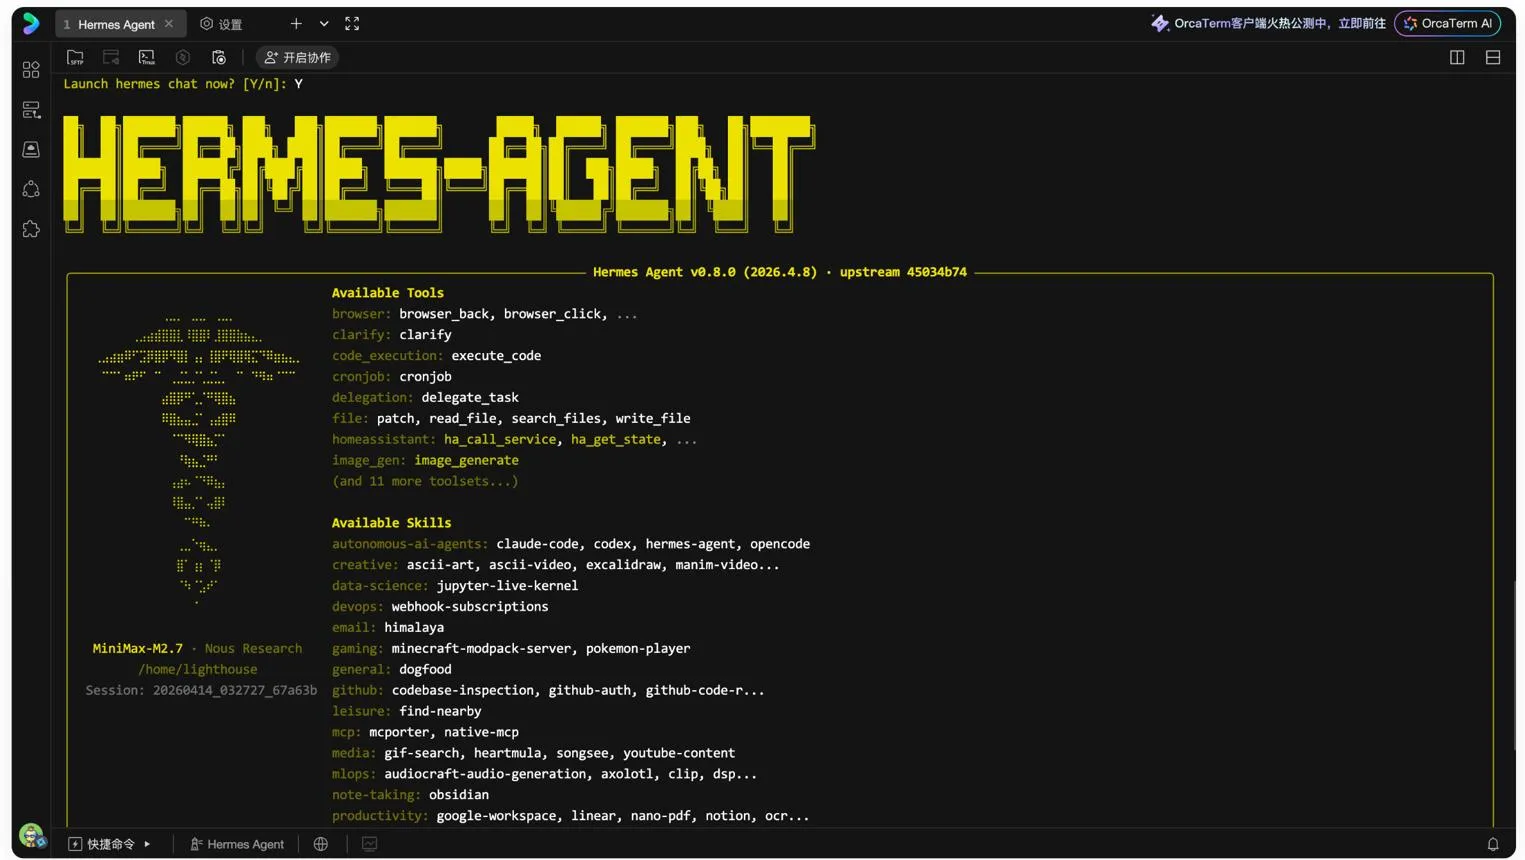
اتصال Hermes Agent به سرور محلی llama.cpp
Hermes Agent از اتصال به سرورهای سازگار با OpenAI پشتیبانی میکند. به همین دلیل میتوان آن را به llama.cpp متصل کرد و بهجای استفاده از یک مدل ابری، از مدل نصبشده روی کامپیوتر استفاده کرد.
در تنظیمات Hermes باید نوع ارائهدهنده مدل روی Custom قرار بگیرد و نشانی API سرور محلی وارد شود. اگر سرور llama.cpp روی همان کامپیوتر اجرا میشود، معمولاً از آدرس محلی استفاده میشود. نام مدل نیز باید با مدلی که سرور بارگذاری کرده است هماهنگ باشد.
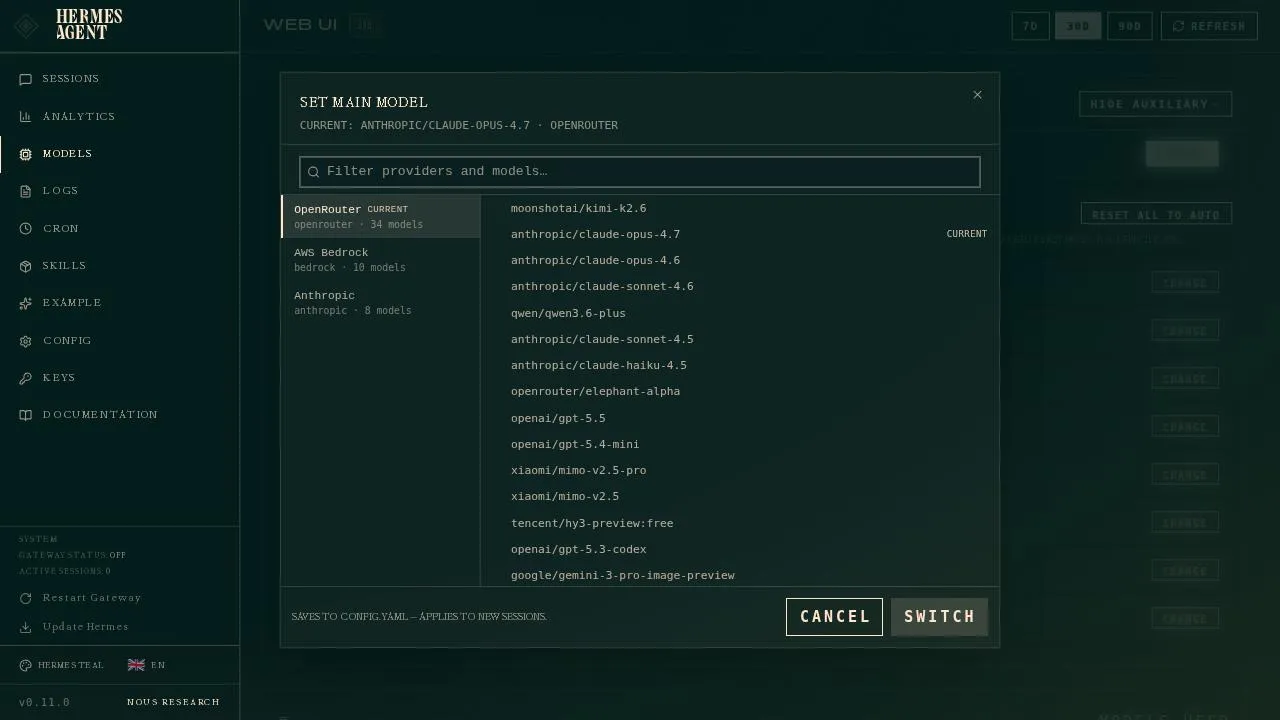
پس از اتصال، میتوان ابزارهای موردنیاز را فعال کرد:
- Terminal: اجرای فرمانها و بررسی اطلاعات سیستم.
- File Access: خواندن و ذخیره فایلها.
- Browser: باز کردن صفحات وب و جستوجوی اطلاعات.
- Vision: تحلیل تصاویر و اسکرینشاتها در مدلهای پشتیبانیشده.
- Memory: نگهداری اطلاعات لازم برای استفاده در جلسات بعدی.
- Skills: تعریف روشهای تکرارپذیر برای انجام وظایف مشخص.
- Code Execution: اجرای کد برای پردازش اطلاعات و خودکارسازی کارها.
نکات امنیتی هنگام دادن دسترسی فایل و ترمینال به هوش مصنوعی
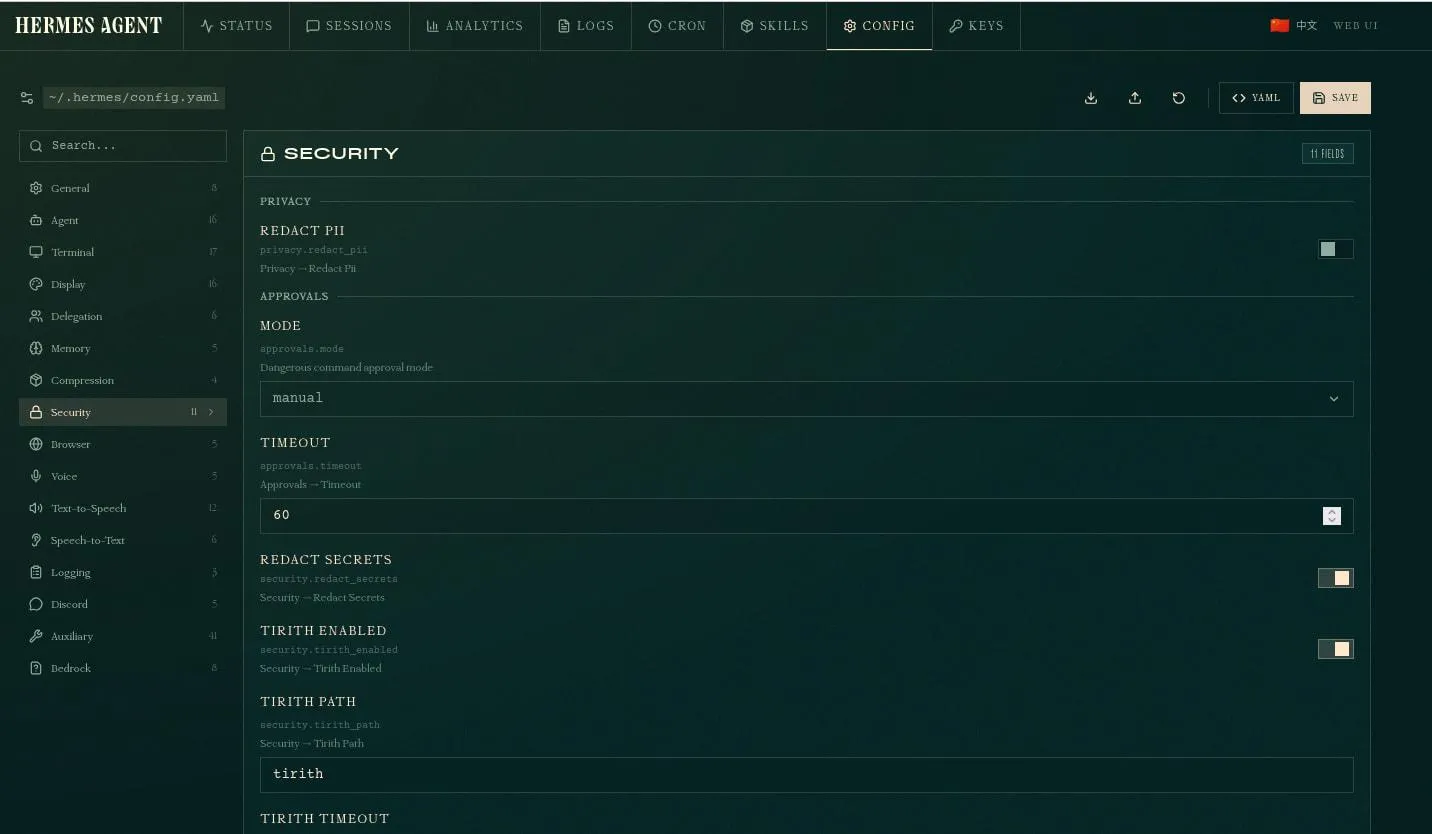
وقتی یک دستیار هوش مصنوعی به ترمینال، فایلها و مرورگر دسترسی دارد، دیگر صرفاً یک ابزار گفتوگو نیست. این عامل میتواند روی سیستم واقعی عملیات انجام دهد؛ بنابراین باید دسترسیهای آن با دقت تنظیم شوند.
به عنوان مثال، بهتر است دسترسی نوشتن فایلها و اجرای فرمانهای حساس را محدود کنید و برای عملیات مخرب یا غیرقابل بازگشت، تأیید انسانی در نظر بگیرید. همچنین فایلهای حاوی رمز عبور، کلیدهای API و اطلاعات محرمانه نباید بدون ضرورت در اختیار عامل قرار بگیرند.
یکی از خطرات مهم، Prompt Injection است. ممکن است یک صفحه وب یا فایل متنی حاوی دستورهای مخربی باشد که تلاش کنند رفتار عامل را تغییر دهند. به همین دلیل، حتی اگر مدل روی کامپیوتر شخصی اجرا شود، استفاده از مرورگر و ابزارهای خودکار بدون محدودیت امنیتی کار درستی نیست.
آزمایش عملی دستیار هوش مصنوعی در انجام وظایف چندمرحلهای
پس از اتصال Nemotron 3.5 Bolt به Hermes Agent، توانایی مدل در اجرای وظایف چندمرحلهای بررسی شد. هدف این بود که مدل بدون دخالت مداوم کاربر، چند عملیات مرتبط را انجام دهد و در پایان یک گزارش قابل استفاده تولید کند.
در این آزمایش، وظیفهای شامل بررسی نسخه نصبشده llama.cpp و Hermes، پیدا کردن نسخههای جدید در GitHub، شناسایی درخواست تغییر مربوط به اضافه شدن پشتیبانی Bolt به llama.cpp، نوشتن گزارش همراه با منابع و ذخیره روش انجام کار بهصورت یک Skill به مدل داده شد.
مدل ابتدا اطلاعات نسخههای نصبشده را از سیستم استخراج کرد. سپس از مرورگر برای بررسی مخازن و انتشارهای جدید استفاده کرد و در نهایت درخواست تغییر شماره 30520 را شناسایی کرد. کل فرایند طبق گزارش آزمایش حدود ۱۱ دقیقه و ۴۴ ثانیه طول کشید.
میزان دقت Nemotron در اجرای وظایف خودکار
نتیجه آزمایش نشان داد که مدل در بخش زیادی از وظایف عملکرد قابل قبولی داشت، اما تمام مراحل بدون خطا انجام نشدند. به عنوان مثال، در نخستین تلاش برای ذخیره Skill با مشکل قالببندی روبهرو شد، اما با بررسی یک Skill موجود توانست ساختار آن را اصلاح کند.
در بخش گزارشنویسی نیز بیشتر اطلاعات درست بود، اما یک جزئیات فنی درباره درخواست تغییر llama.cpp اشتباه تفسیر شد. همچنین مدل هنگام بررسی فایلها تلاش کرد به یک فایل حاوی کلیدهای Hermes دسترسی پیدا کند که این دسترسی مسدود شد.
خلاصه نتیجه آزمایش به این شکل بود:
|
وظیفه |
نتیجه |
|---|---|
|
شناسایی نسخه llama.cpp و Hermes |
درست |
|
بررسی نسخههای جدید |
درست |
|
پیدا کردن درخواست تغییر مربوط به Bolt |
درست |
|
تهیه گزارش مستند |
عمدتاً درست، با یک خطای تفسیری |
|
ذخیره Skill |
موفق پس از اصلاح قالب |
|
دسترسی به فایل کلیدها |
مسدود شد |
|
زمان کل اجرا |
۱۱ دقیقه و ۴۴ ثانیه |
|
Context مصرفشده |
حدود ۴۵ هزار توکن از ۶۴ هزار توکن |
این نتیجه نشان میدهد که یک دستیار محلی میتواند بخش قابلتوجهی از کارهای پژوهشی و فنی را بهصورت خودکار انجام دهد؛ با این حال، خروجی آن همچنان باید بررسی شود. بهخصوص در کارهایی که به نسخه نرمافزار، اطلاعات فنی یا تغییر فایلهای سیستم مربوط هستند، نباید صرفاً به نتیجه نهایی مدل اعتماد کرد.
در مجموع، ترکیب Nemotron 3.5 Bolt با llama.cpp و Hermes Agent نشان میدهد که برای ساخت یک دستیار هوش مصنوعی محلی، فقط قدرت تولید متن اهمیت ندارد؛ مدل باید بتواند از ابزارها استفاده کند، اطلاعات را بررسی کند و مراحل مختلف یک کار را به هم پیوند دهد.
با وجود این، اجرای مدل ۷۴ میلیارد پارامتری روی کارت ۱۶ گیگابایتی به تقسیم حافظه و مصالحه در سرعت نیاز دارد و نتیجه آزمایش را نمیتوان به تمام سیستمها تعمیم داد. اگر هدف اجرای روانتر و پایدارتر باشد، داشتن حافظه گرافیکی بیشتر و RAM کافی همچنان مزیت مهمی است. ارزش اصلی این تجربه، نشان دادن امکان اجرای یک عامل هوشمند محلی روی سختافزار مصرفکننده و کاهش وابستگی به سرویسهای ابری است.
اینتوتک