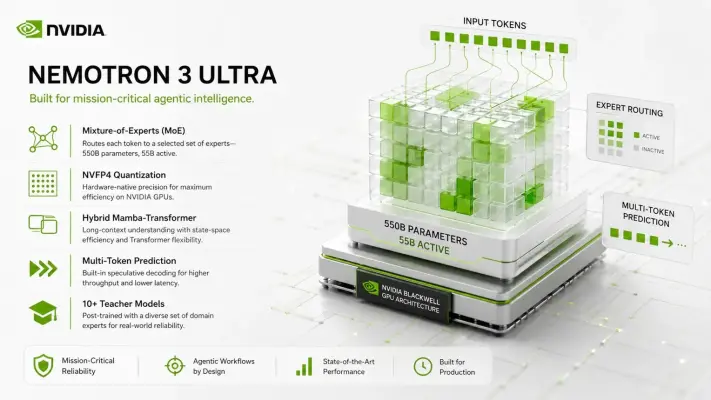
اجرای مدلهای زبانی بزرگ روی کامپیوتر شخصی دیگر صرفاً به مدلهای کوچک و کارتهای گرافیک گرانقیمت محدود نیست. با استفاده از تکنیکهایی مانند کوانتایزیشن و تقسیم پردازش بین حافظه گرافیکی و RAM میتوان بعضی مدلهای بسیار بزرگ را روی سختافزار ضعیفتر نیز اجرا کرد؛ البته اجرای مدل با سرعت مناسب و بدون خطا، مسئلهای جداگانه است.
یکی از نمونههای جالب این رویکرد، اجرای مدل Nemotron 3.5 Bolt 74B-A9B متعلق به NVIDIA با کمک llama.cpp و اتصال آن به است. این ترکیب میتواند یک کامپیوتر شخصی را به دستیار هوش مصنوعی محلی تبدیل کند که علاوه بر پاسخگویی، توانایی استفاده از مرورگر، ترمینال و فایلها و انجام وظایف چندمرحلهای را نیز دارد.