llama.cpp

اجرای مدل هوش مصنوعی ۷۴ میلیاردی Nemotron با llama.cpp و Hermes Agent

اجرای مدل‌های زبانی بزرگ روی کامپیوتر شخصی دیگر صرفاً به مدل‌های کوچک و کارت‌های گرافیک گران‌قیمت محدود نیست. با استفاده از تکنیک‌هایی مانند کوانتایزیشن و تقسیم پردازش بین حافظه گرافیکی و RAM می‌توان بعضی مدل‌های بسیار بزرگ را روی سخت‌افزار ضعیف‌تر نیز اجرا کرد؛ البته اجرای مدل با سرعت مناسب و بدون خطا، مسئله‌ای جداگانه است.

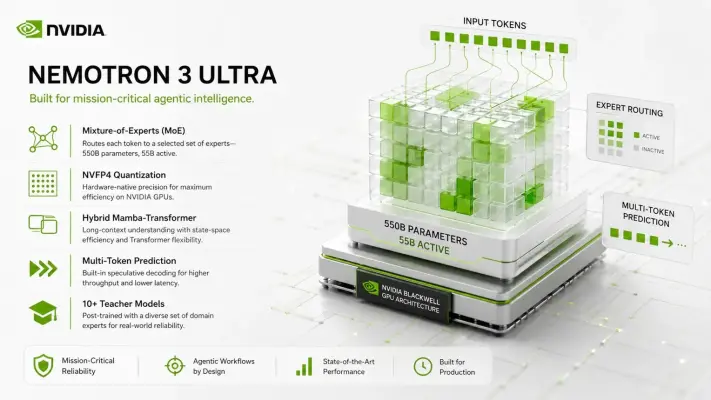
یکی از نمونه‌های جالب این رویکرد، اجرای مدل Nemotron 3.5 Bolt 74B-A9B متعلق به NVIDIA با کمک llama.cpp و اتصال آن به است. این ترکیب می‌تواند یک کامپیوتر شخصی را به دستیار هوش مصنوعی محلی تبدیل کند که علاوه بر پاسخ‌گویی، توانایی استفاده از مرورگر، ترمینال و فایل‌ها و انجام وظایف چندمرحله‌ای را نیز دارد.

مقایسه ۴ مدل هوش مصنوعی آفلاین در تحلیل فایل اکسل؛ کدام مدل محاسبات دقیق‌تری دارد؟

اجرای روی کامپیوترهای شخصی به لطف مدل‌های زبانی کوچک آسان‌تر شده است. امروزه می‌توان مدل‌هایی با چند میلیارد پارامتر را روی لپ‌تاپ یا کامپیوتر مجهز به کارت گرافیک میان‌رده اجرا کرد و بدون ارسال اطلاعات به سرویس‌های ابری، از آن‌ها برای تحلیل متن، برنامه‌نویسی و بررسی فایل‌ها کمک گرفت.

اما آیا برای تحلیل فایل اکسل و محاسبه قیمت محصولات قابل اعتماد است؟ مقایسه چهار مدل Gemma 4 و Phi-4 Mini و Ministral 3 نشان می‌دهد حتی مدل‌هایی که اطلاعات فایل را درست می‌خوانند، ممکن است در محاسبه میانگین، تشخیص ارزان‌ترین محصول یا تشخیص اطلاعات ناموجود اشتباه کنند.

بهترین ابزار اجرای هوش مصنوعی محلی برای شروع؛ مقایسه LM Studio، Ollama، KoboldCpp و llama.cpp

اگر می‌خواهید مدل‌های هوش مصنوعی را روی کامپیوتر خودتان اجرا کنید، انتخاب ابزار مناسب به میزان تجربه و کنترل موردنیاز شما بستگی دارد. ابزارهایی مانند Ollama و llama.cpp بیشتر روی اجرای مدل و کنترل فنی تمرکز دارند، در حالی که LM Studio و Msty محیط گرافیکی کامل‌تری ارائه می‌کنند. LM Studio امکان جست‌وجو و دانلود مدل و اجرای آن در محیط چت را مستقیماً از داخل برنامه فراهم می‌کند.

در مقابل، KoboldCpp برای اجرای مدل‌های GGUF و تنظیم دقیق گزینه‌هایی مانند لایه‌های GPU و اندازه کانتکست امکانات بیشتری دارد.

آخرین دیدگاه‌ها
۲۰۰ دیدگاه و پاسخ آخر
حراج بلک فرایدی هوشمندسازی خانه