برای اجرای مدلهای هوش مصنوعی بهصورت محلی روی کارت گرافیک ۸ گیگابایتی، صرفاً انتخاب یک مدل کمحجم کافی نیست؛ تنظیماتی مثل حالت تفکر، روش نمونهبرداری و اندازه پنجره متن نیز مستقیماً بر سرعت و کیفیت پاسخ و میزان مصرف حافظه تأثیر میگذارند. در چنین سیستمی بهتر است تنظیمات را متناسب با سختافزار انتخاب کنید، نه اینکه دقیقاً از توصیههایی پیروی کنید که برای مدلهای ابری و سرورهای قدرتمند نوشته شدهاند.
چرا تنظیمات هوش مصنوعی محلی با مدلهای ابری متفاوت است؟
مدلهای ابری روی سرورهایی با حافظه و توان پردازشی بسیار زیاد اجرا میشوند؛ اما هنگام اجرای هوش مصنوعی محلی، تمام منابع سیستم باید بین مدل و برنامههای دیگر تقسیم شوند. اگر کارت گرافیک شما فقط ۸ گیگابایت VRAM داشته باشد، باز گذاشتن مرورگر، نرمافزار ویرایش تصویر و ابزارهای جانبی نیز میتواند فضای در دسترس مدل را کاهش دهد.
به همین دلیل، تنظیماتی که برای یک مدل ابری مناسب هستند لزوماً برای اجرای مدل زبانی محلی بهترین انتخاب نیستند. در اجرای محلی باید به حجم مدل، مقدار حافظه موردنیاز برای مکالمه، سرعت تولید پاسخ و منابع آزاد سیستم توجه کنید.
هدف این نیست که همیشه بزرگترین مدل یا طولانیترین پنجره متن را انتخاب کنید؛ بلکه باید مدلی را اجرا کنید که با کمترین فشار به سختافزار، وظیفه موردنظر را بهخوبی انجام دهد.
غیرفعال کردن حالت Thinking برای کاهش مصرف حافظه
حالت Thinking یا Reasoning به مدل اجازه میدهد پیش از ارائه پاسخ نهایی، فرایند استدلال خود را انجام دهد. این قابلیت برای مسائل پیچیده، برنامهنویسی دشوار و درخواستهایی که چند مرحله دارند مفید است؛ اما همیشه به آن نیاز ندارید.
در مدلهای محلی، متن ورودی، تاریخچه مکالمه، فایلهای اضافهشده و توکنهای مربوط به فرایند تفکر همگی میتوانند بخشی از پنجره متن را اشغال کنند. بنابراین فعال بودن دائمی Thinking ممکن است بدون اینکه ارزش زیادی به پاسخ اضافه کند، مصرف منابع را افزایش دهد.
اگر بیشتر از مدل برای پرسشهای روزمره، اصلاح کدهای کوتاه، خلاصهسازی و نوشتن متن استفاده میکنید، بهتر است حالت تفکر را در صورت امکان غیرفعال کنید. در مقابل، برای تحلیل چندمرحلهای یا حل مسئله دشوار میتوانید آن را دوباره فعال کنید.
نکته مهم این است که غیرفعال کردن Thinking الزاماً به معنای افزایش کیفیت پاسخ نیست؛ این کار بیشتر برای کاهش سربار و کوتاهتر شدن فرایند تولید پاسخ کاربرد دارد. برای درخواستهایی که به استدلال عمیق نیاز دارند، استفاده از یک مدل قویتر یا فعال کردن Reasoning میتواند نتیجه بهتری داشته باشد.
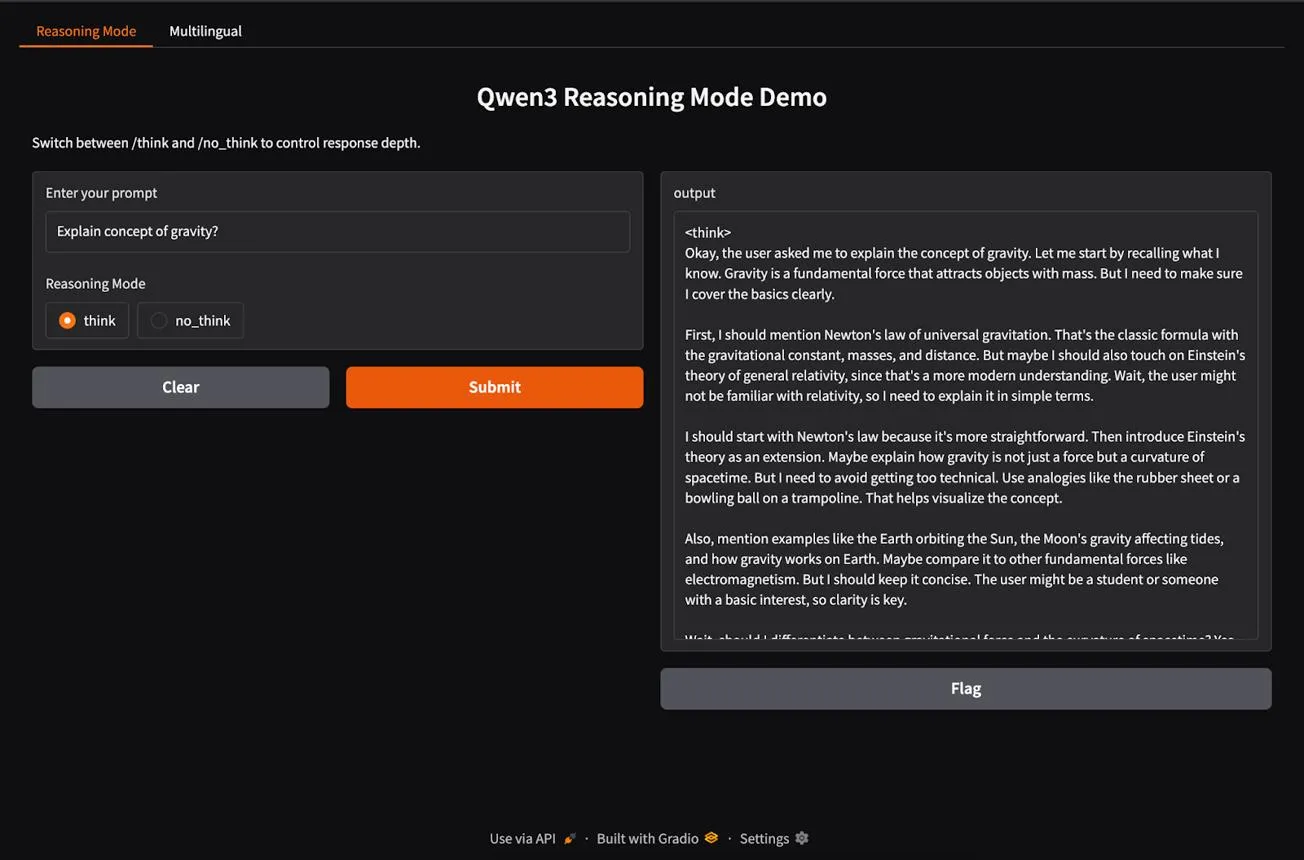
فعال کردن Min P برای کنترل بهتر خروجی مدل
یکی از تنظیمات مفید در اجرای مدلهای زبانی محلی، پارامتر Min P است. این گزینه روی روش انتخاب توکن بعدی تأثیر میگذارد و توکنهایی را که احتمال انتخاب آنها نسبت به محتملترین گزینه بسیار پایین است، از فرایند نمونهبرداری کنار میگذارد.
درک این تنظیم ساده است: وقتی Temperature را افزایش میدهید، مدل آزادی بیشتری برای انتخاب کلمات و ساخت پاسخهای متنوع دارد. با این حال، افزایش بیشازحد تصادفی بودن ممکن است باعث پاسخهای نامرتبط، تکراری یا غیرطبیعی شود. Min P میتواند بخشی از این انتخابهای کماحتمال را محدود کند.
برای شروع میتوانید این مقادیر را امتحان کنید:
- Min P بین ۰٫۰۳ تا ۰٫۰۵: نقطه شروع مناسبی برای آزمایش در بسیاری از مدلها است.
- Temperature حدود ۰٫۲ تا ۰٫۳: برای پاسخهای دقیقتر و وظایف تحلیلی مناسبتر است.
- Temperature بالاتر از ۰٫۳: اگر پاسخها بیشازحد پراکنده میشوند، میتوانید Min P را بهتدریج افزایش دهید.
این اعداد نسخهای ثابت برای تمام مدلها نیستند. رفتار مدلهای مختلف، نسخه کوانتایز و نرمافزار اجراکننده میتواند نتیجه را تغییر دهد. بهتر است هر بار فقط یک پارامتر را تغییر دهید تا متوجه شوید کدام تنظیم واقعاً کیفیت خروجی را بهتر میکند.
تنظیم Min P در نرمافزارهای اجرای مدل محلی
در ابزارهایی مانند llama.cpp میتوانید Min P را از طریق تنظیمات نمونهبرداری یا پارامترهای خط فرمان تغییر دهید. در نسخههای مختلف LM Studio و سایر رابطهای گرافیکی نیز ممکن است این گزینه در بخش تنظیمات پیشرفته تولید پاسخ قرار داشته باشد.
در llama.cpp مقدار پیشفرض Min P در مستندات فعلی ابزار ۰٫۰۵ ذکر شده است و مقدار صفر آن را غیرفعال میکند. اگر نرمافزار شما این پارامتر را نمایش نمیدهد، ممکن است رابط کاربری یا موتور اجرای مدل از آن پشتیبانی نکند.
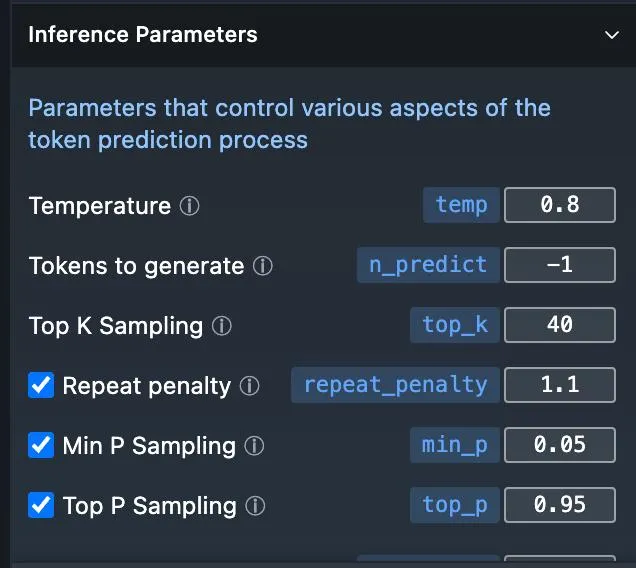
کاهش Context Window برای آزاد کردن حافظه VRAM
Context Window یا پنجره متن مشخص میکند مدل در هر لحظه چه مقدار از ورودیها و تاریخچه مکالمه را میتواند در نظر بگیرد. این ظرفیت فقط به پیام فعلی محدود نیست و پیامهای قبلی، پاسخهای مدل و محتوای فایلهایی که به مکالمه اضافه میکنید نیز بخشی از آن را اشغال میکنند.
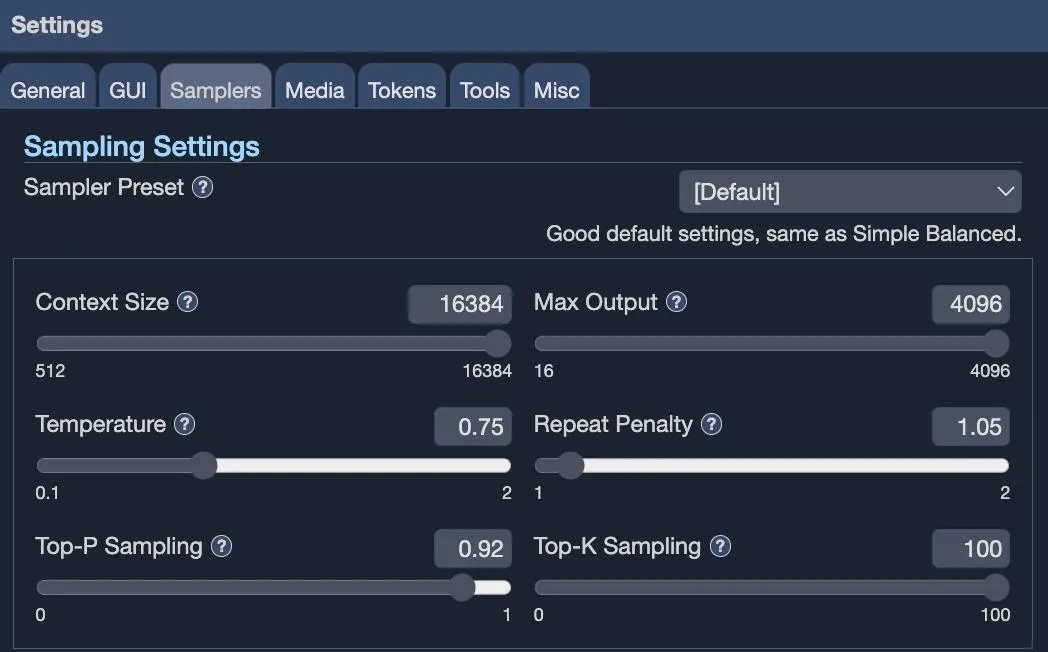
هرچه پنجره متن بزرگتر باشد، مدل میتواند اطلاعات بیشتری را در یک مکالمه نگه دارد؛ اما این قابلیت هزینه حافظه دارد. بخشی از حافظه موردنیاز با عنوان KV Cache مصرف میشود که با افزایش تعداد توکنهای موجود در Context Window بزرگتر میشود.
در نتیجه ممکن است یک مدل از نظر حجم فایل در کارت گرافیک شما جا شود، اما با افزایش طول مکالمه با خطای کمبود حافظه مواجه شوید. این موضوع بهخصوص در کارتهای گرافیک ۸ گیگابایتی اهمیت دارد.
چه مقدار Context برای کارت گرافیک ۸ گیگابایتی مناسب است؟
برای شروع، به جای انتخاب حداکثر ظرفیت پشتیبانیشده مدل، مقدار پایینتری را امتحان کنید. بازه ۴ تا ۱۶ هزار توکن میتواند نقطه شروع محتاطانهای برای بسیاری از مدلهای کوچک باشد؛ البته مقدار مناسب به معماری مدل، نوع کوانتایز و میزان حافظه آزاد بستگی دارد.
اگر مدل و نرمافزار شما بدون مشکل اجرا میشوند، میتوانید Context را بهتدریج افزایش دهید. در مقابل، اگر هنگام شروع تولید پاسخ یا ارسال پیامهای طولانی با خطای کمبود حافظه روبهرو میشوید، کاهش این مقدار یکی از نخستین راهکارهایی است که باید امتحان کنید.
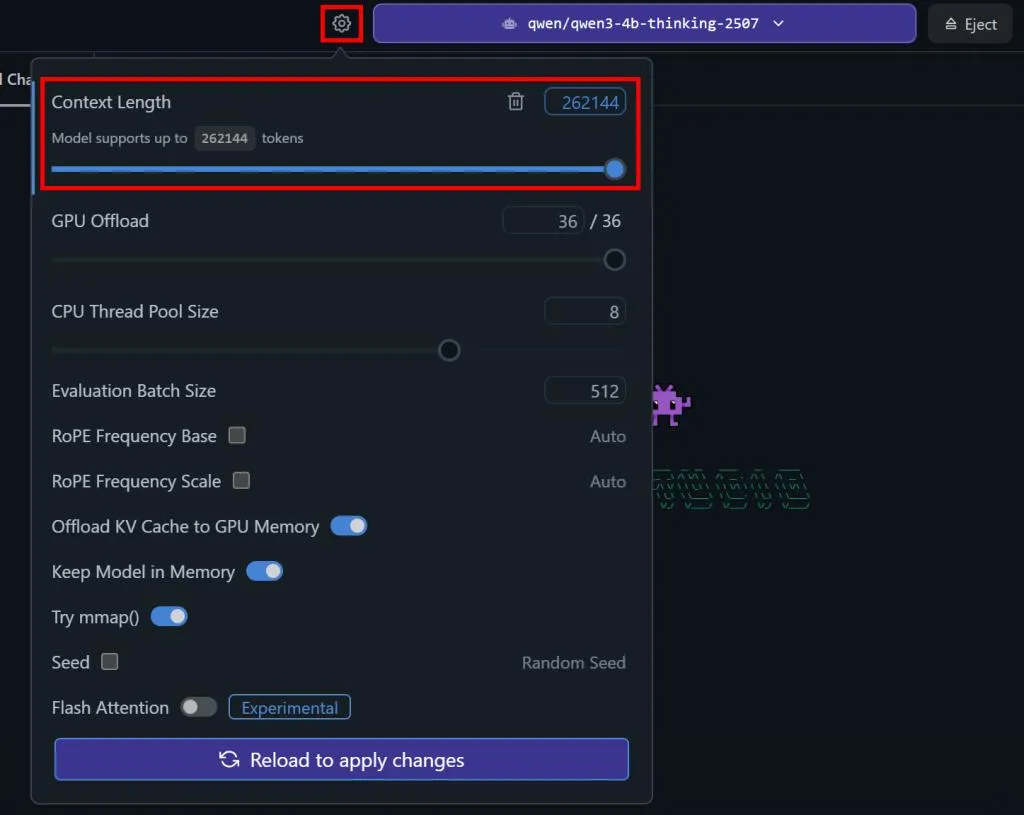
برای مدیریت بهتر حافظه به این نکات توجه کنید:
- تاریخچه مکالمههای غیرضروری را در یک گفتوگوی طولانی نگه ندارید.
- فایلهای حجیم را فقط زمانی به مدل بدهید که واقعاً به آنها نیاز دارید.
- هنگام اجرای مدل، برنامههای سنگین و غیرضروری را ببندید.
- اگر نرمافزار پشتیبانی میکند، تنظیم دقت KV Cache را نیز بررسی کنید؛ استفاده از دقت پایینتر میتواند مصرف حافظه را کاهش دهد، هرچند ممکن است روی کیفیت اثر بگذارد.
به خاطر داشته باشید که ظرفیت اسمی Context در مشخصات مدل به معنای امکان استفاده از تمام آن روی کارت گرافیک شما نیست. برای مثال، پشتیبانی یک مدل از ۲۵۶ هزار توکن به این معنا نیست که کارت ۸ گیگابایتی میتواند آن را با همین ظرفیت و بدون محدودیت اجرا کند.
ابتدا مدلهای هوش مصنوعی کوچکتر را امتحان کنید
یکی از اشتباهات رایج هنگام اجرای هوش مصنوعی محلی این است که از همان ابتدا سراغ بزرگترین مدل ممکن میروید. مدلهای بزرگتر معمولاً توانایی بیشتری در انجام وظایف پیچیده دارند؛ اما به حافظه بیشتر و منابع پردازشی بالاتری نیاز دارند.
در یک سیستم با کارت گرافیک ۸ گیگابایتی، بهتر است ابتدا مدلهای کوچکتر را امتحان کنید. اگر یک مدل ۲ تا ۴ میلیارد پارامتری بتواند وظیفه موردنظر شما را با کیفیت قابل قبول انجام دهد، اجرای مدل بزرگتر لزوماً مزیت خاصی ایجاد نمیکند.
به عنوان مثال، میتوانید از مدلهای کوچک خانواده Qwen و Gemma برای مکالمه روزمره، تولید متن و اصلاح کدهای ساده استفاده کنید. اگر نتیجه رضایتبخش نبود، سراغ مدلهای بزرگتر بروید.
برای چه کارهایی مدل کوچکتر کافی است؟
انتخاب مدل باید بر اساس نوع درخواست انجام شود، نه صرفاً تعداد پارامترهای آن. به طور کلی:
- مکالمه روزمره و پرسشهای ساده: مدلهای کوچک Gemma و Qwen میتوانند گزینه مناسبی باشند.
- اصلاح کدهای کوتاه: مدلهای کوچک برنامهنویسی برای تغییرات جزئی و رفع ایرادهای ساده کاربرد دارند.
- خلاصهسازی متن: اگر حجم متن ورودی زیاد نباشد، بسیاری از مدلهای کمحجم از عهده این کار برمیآیند.
- تحلیل پیچیده و برنامهنویسی چندمرحلهای: بهتر است از مدل قویتر استفاده کنید؛ حتی اگر لازم باشد بخشی از کار را به یک سرویس ابری بسپارید.
انتخاب مدل مناسب با توجه به حافظه کارت گرافیک
صرفاً حجم فایل مدل را ملاک قرار ندهید. مقدار VRAM موردنیاز شامل وزنهای مدل، KV Cache، بافرهای پردازشی و حافظه موردنیاز نرمافزار اجراکننده است.
کوانتایز Q4 معمولاً نقطه شروع مناسبی برای اجرای مدلهای کوچک روی سختافزار محدود است. با این حال، حتی یک مدل ۸ میلیارد پارامتری با کوانتایز چهار بیتی نیز ممکن است همراه با Context طولانی در حافظه ۸ گیگابایتی جا نشود. در چنین شرایطی باید اندازه Context را کاهش دهید یا بخشی از مدل را با استفاده از حافظه سیستم اجرا کنید؛ البته اجرای ترکیبی میتواند سرعت را کاهش دهد.
بهترین تنظیمات برای اجرای روان مدل زبانی روی GPU هشت گیگابایتی
برای استفاده روزمره از هوش مصنوعی محلی، لازم نیست تمام تنظیمات را به حداکثر برسانید. ترکیبی از مدل کوچکتر، Context کنترلشده و تنظیمات نمونهبرداری مناسب معمولاً تجربه روانتری ایجاد میکند.
پیشنهاد میشود از این رویکرد شروع کنید:
- اندازه مدل: ابتدا مدلهای ۲ تا ۴ میلیارد پارامتری را امتحان کنید و در صورت نیاز به مدلهای بزرگتر بروید.
- نوع کوانتایز: Q4 را به عنوان نقطه شروع در نظر بگیرید.
- Context Window: ابتدا بازه ۴ تا ۱۶ هزار توکن را آزمایش کنید.
- Thinking: برای کارهای ساده غیرفعال و برای وظایف پیچیده فعال کنید.
- Min P: مقدار ۰٫۰۳ تا ۰٫۰۵ را آزمایش کنید و نتیجه را با تنظیمات پیشفرض مقایسه کنید.
- Temperature: برای کارهای دقیق مقدار پایینتر و برای تولید متن خلاقانه مقدار بالاتر را امتحان کنید.
در نهایت، بهترین تنظیمات هوش مصنوعی محلی برای هر سیستم متفاوت است. حتی دو کامپیوتر با کارت گرافیک یکسان ممکن است به دلیل تفاوت در حافظه RAM، نرمافزار اجراکننده، مدل انتخابی و برنامههای باز، عملکرد متفاوتی داشته باشند. بنابراین بهتر است هر تنظیم را بهصورت جداگانه آزمایش کنید و تنها زمانی آن را تغییر دهید که بهبود واقعی در سرعت یا کیفیت پاسخ مشاهده میکنید.
اینتوتک