هوش مصنوعی محلی

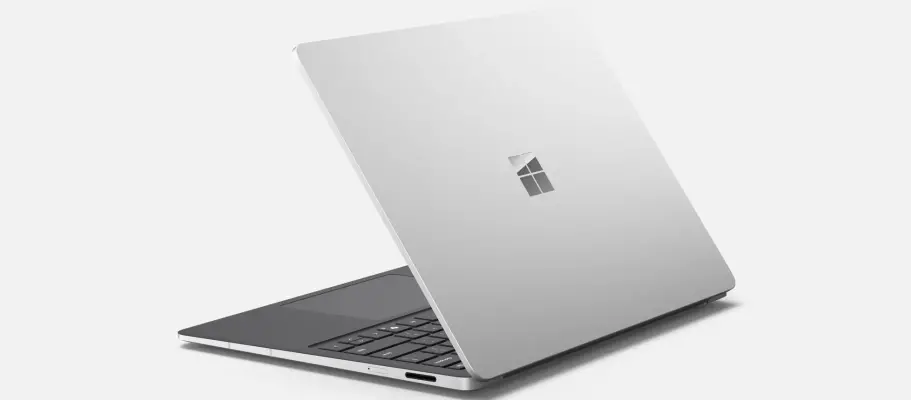
بررسی RTX Spark انویدیا؛ عملکرد هوش مصنوعی محلی و بازی در Surface Laptop Ultra

رایانه‌های شخصی در حال ورود به دوره‌ای هستند که اجرای مدل‌های هوش مصنوعی به‌صورت محلی، بدون وابستگی دائمی به سرویس‌های ابری، اهمیت بیشتری پیدا می‌کند. پلتفرم RTX Spark انویدیا با ترکیب پردازنده مرکزی و گرافیکی قدرتمند و حافظه یکپارچه، برای همین کاربرد طراحی شده است. مایکروسافت نیز با لپ‌تاپ Surface Laptop Ultra تلاش می‌کند این توان پردازشی را در قالب یک دستگاه ویندوزی قابل‌حمل ارائه دهد.

این پلتفرم در اجرای مدل‌های هوش مصنوعی محلی عملکرد امیدوارکننده‌ای دارد؛ اما برای بازی‌های سنگین، محدودیت‌هایی مانند پهنای باند حافظه، قدرت پردازنده مرکزی و اجرای بازی‌های مبتنی بر معماری x86 روی همچنان اهمیت دارند. بنابراین، ارزش خرید آن به این بستگی دارد که اجرای هوش مصنوعی محلی برای شما اولویت دارد یا بازی و عملکرد گرافیکی.
۵ جایگزین متن‌باز ChatGPT و Claude و Perplexity برای کاهش هزینه هوش مصنوعی

پرداخت هزینه برای چند سرویس هوش مصنوعی مختلف خیلی سریع می‌تواند به یک هزینه ماهانه قابل توجه تبدیل شود. مشکل مهم‌تر این است که برخلاف سرویس‌هایی مانند موسیقی، فضای ابری یا طراحی گرافیکی که هرکدام کاربرد مشخصی دارند، بسیاری از سرویس‌های هوش مصنوعی در بخش‌هایی از قابلیت‌های خود با یکدیگر هم‌پوشانی دارند.

اگر بیشتر کارهای روزمره شما شامل گفت‌وگو با هوش مصنوعی، جست‌وجوی وب، خلاصه‌سازی اسناد، برنامه‌نویسی، طراحی یا تحقیق باشد، لازم نیست الزاماً برای انجام هرکدام یک اشتراک جداگانه تهیه کنید. بخشی از این کارها را می‌توان با ابزارهای متن‌باز و اجرای مدل‌های هوش مصنوعی روی کامپیوتر انجام داد.

آموزش اجرای هوش مصنوعی محلی در BrowserOS با LM Studio و Ollama

مرورگرهای مجهز به هوش مصنوعی معمولاً برای پاسخ‌گویی به پرسش‌ها یا خلاصه‌کردن صفحات وب به سرویس‌های ابری متکی هستند. یک روش متفاوت این است که مدل زبانی را روی کامپیوتر اجرا کنید و مرورگر را به همان مدل محلی متصل کنید. در این حالت پردازش گفت‌وگو با مدل روی سیستم خودتان انجام می‌شود و برای استفاده از مدل نیازی به اشتراک ماهانه یا کلید API سرویس‌های ابری ندارید.

BrowserOS از اتصال به مدل‌های محلی از طریق ابزارهایی مانند LM Studio و Ollama پشتیبانی می‌کند. مدل محلی می‌تواند برای خلاصه‌کردن صفحه فعلی، پرسیدن سؤال درباره محتوای صفحه و مقایسه اطلاعات چند تب کاربرد داشته باشد.

بهترین ابزار اجرای هوش مصنوعی محلی برای شروع؛ مقایسه LM Studio، Ollama، KoboldCpp و llama.cpp

اگر می‌خواهید مدل‌های هوش مصنوعی را روی کامپیوتر خودتان اجرا کنید، انتخاب ابزار مناسب به میزان تجربه و کنترل موردنیاز شما بستگی دارد. ابزارهایی مانند Ollama و llama.cpp بیشتر روی اجرای مدل و کنترل فنی تمرکز دارند، در حالی که LM Studio و Msty محیط گرافیکی کامل‌تری ارائه می‌کنند. LM Studio امکان جست‌وجو و دانلود مدل و اجرای آن در محیط چت را مستقیماً از داخل برنامه فراهم می‌کند.

در مقابل، KoboldCpp برای اجرای مدل‌های GGUF و تنظیم دقیق گزینه‌هایی مانند لایه‌های GPU و اندازه کانتکست امکانات بیشتری دارد.

آموزش ساخت هوش مصنوعی محلی با Ollama و RAG؛ جست‌وجو در PDF و اسناد شخصی

ساخت دستیار تحقیقاتی هوش مصنوعی به‌صورت کاملاً محلی؛ اجرای RAG با Ollama و اسناد شخصی

اگر با PDF، مقاله، گزارش یا مجموعه‌ای از اسناد زیاد سروکار دارید، می‌توانید به‌جای آپلود آن‌ها در سرویس‌های ابری، یک دستیار تحقیقاتی هوش مصنوعی را روی کامپیوتر خودتان راه‌اندازی کنید. ترکیب Ollama با یک مدل زبانی محلی، مدل Embedding و ابزارهایی مانند Open WebUI یا AnythingLLM امکان ساخت یک سیستم RAG را فراهم می‌کند که اطلاعات موردنیاز را از میان فایل‌های شخصی پیدا کرده و در اختیار مدل قرار می‌دهد.

مزیت اصلی این روش فقط رایگان بودن نیست؛ اسناد در حالت اجرای کاملاً محلی روی سیستم باقی می‌مانند و برای پردازش آن‌ها به ارسال فایل به یک سرویس ابری نیاز ندارید. خود Ollama نیز اعلام می‌کند که در اجرای محلی، داده و محتوای پردازش‌شده روی دستگاه کاربر باقی می‌ماند.

معرفی ۸ مدل هوش مصنوعی لوکال برای کارت گرافیک‌هایی با ۸ گیگابایت رم یا کمتر

اجرای مدل‌های هوش مصنوعی به‌صورت محلی معمولاً به مقدار زیادی VRAM نیاز دارد و همه کاربران نیز به کارت گرافیکی جدید و قدرتمندی با بیش از ۲۰ گیگابایت VRAM دسترسی ندارند. با این حال، چند مدل سبک و در عین حال توانمند وجود دارند که بسته به نوع استفاده می‌توانند حتی با ۸ گیگابایت VRAM یا کمتر نیز عملکرد قابل‌قبولی ارائه دهند.

این مدل‌ها برای کاربران دارای کارت‌های گرافیک NVIDIA و AMD جذاب هستند و می‌توانند امکان اجرای مدل‌های زبانی بزرگ را روی سخت‌افزارهای قدیمی‌تر فراهم کنند. با اینتوتک همراه باشید تا مدل‌های بهینه برای رم ویدیویی ۸ گیگابایت کمتر را معرفی کنیم و بنچمارکی از مدل‌های مختلف ارایه کنیم.

آخرین دیدگاه‌ها
۲۰۰ دیدگاه و پاسخ آخر
حراج بلک فرایدی هوشمندسازی خانه