مدلهای هوش مصنوعی محلی به شما اجازه میدهند بدون وابستگی دائمی به سرویسهای آنلاین، کارهایی مانند برنامهنویسی، خلاصهسازی متن و مدیریت اسناد را انجام دهید. با این حال، اجرای سریع یک مدل روی کامپیوتر همیشه به معنای دریافت پاسخهای دقیق نیست. انتخاب نسخه مناسب مدل، تنظیم میزان کوانتایز و استفاده از قالب گفتوگوی صحیح، نقش مهمی در کیفیت خروجی دارند؛ بهخصوص اگر کارت گرافیک شما حافظه محدودی داشته باشد.
برای اجرای بهتر مدل زبانی بزرگ یا LLM روی سختافزارهای معمولی، لازم نیست همیشه سراغ مدلهای بزرگتر یا نسخههای سنگینتر بروید. گاهی انتخاب یک مدل کوچکتر با دقت مناسب یا استفاده از معماری متخصصان ترکیبی میتواند نتیجه بهتری داشته باشد.
چرا کوانتایز مدل هوش مصنوعی اهمیت دارد؟
کوانتایز یا Quantization روشی برای کاهش دقت عددی وزنهای مدل است تا حجم فایل و میزان حافظه موردنیاز برای اجرای آن کمتر شود. این روش کمک میکند مدلهای زبانی بزرگ روی کامپیوترهایی با کارت گرافیک ضعیفتر هم اجرا شوند؛ اما میزان فشردهسازی میتواند بر کیفیت پاسخها اثر بگذارد.
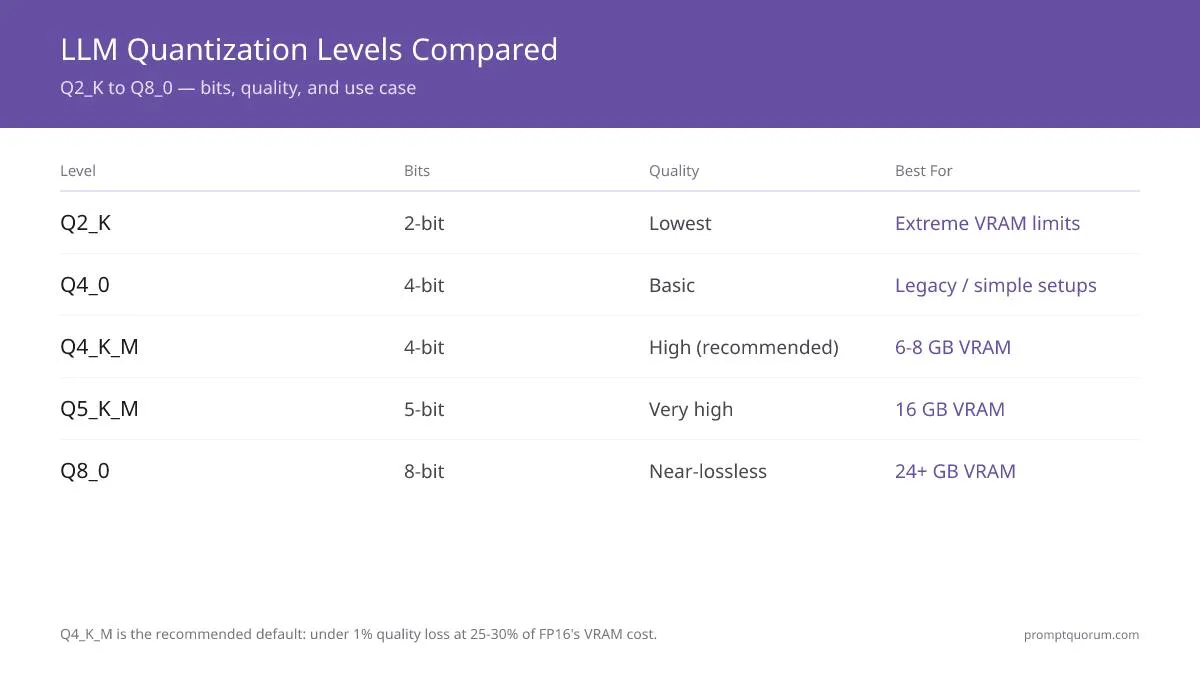
در نام نسخههای مختلف مدل، عبارتهایی مانند Q2، Q3، Q4 و Q5 نشاندهنده سطح کوانتایز هستند. به طور معمول، هرچه تعداد بیتها کمتر باشد، حافظه کمتری نیاز است؛ اما احتمال افت کیفیت نیز بیشتر میشود. البته نتیجه دقیق به معماری مدل، روش کوانتایز و نوع وظیفه بستگی دارد.
مدل Q4 بهتر است یا Q5؟
برای بسیاری از کاربران، مدل Q4 نقطه شروع مناسبی است؛ زیرا معمولاً تعادل خوبی میان حجم، سرعت و کیفیت برقرار میکند. اگر حافظه گرافیکی بیشتری در اختیار دارید و دقت پاسخها برایتان اهمیت بالاتری دارد، مدل Q5 هم ارزش امتحان کردن دارد.
تفاوت نسخهها را میتوان به این شکل خلاصه کرد:
- Q2 و Q3: حجم کمتر و مناسب سختافزارهای بسیار محدود؛ با احتمال بیشتر افت دقت، پاسخهای نامربوط یا تکرارهای بیپایان.
- Q4: انتخاب متعادل برای اجرای مدل هوش مصنوعی محلی روی بسیاری از کامپیوترهای شخصی.
- Q5: مصرف حافظه بیشتر از Q4، اما در برخی مدلها حفظ بهتر کیفیت پاسخها.
- Q8: کیفیت نزدیکتر به نسخههای دقیقتر، با نیاز بیشتر به حافظه.
- BF16 یا FP16: نسخههایی با دقت عددی بالاتر که معمولاً حافظه بسیار بیشتری میخواهند.
چرا مدل Q2 همیشه انتخاب خوبی نیست؟
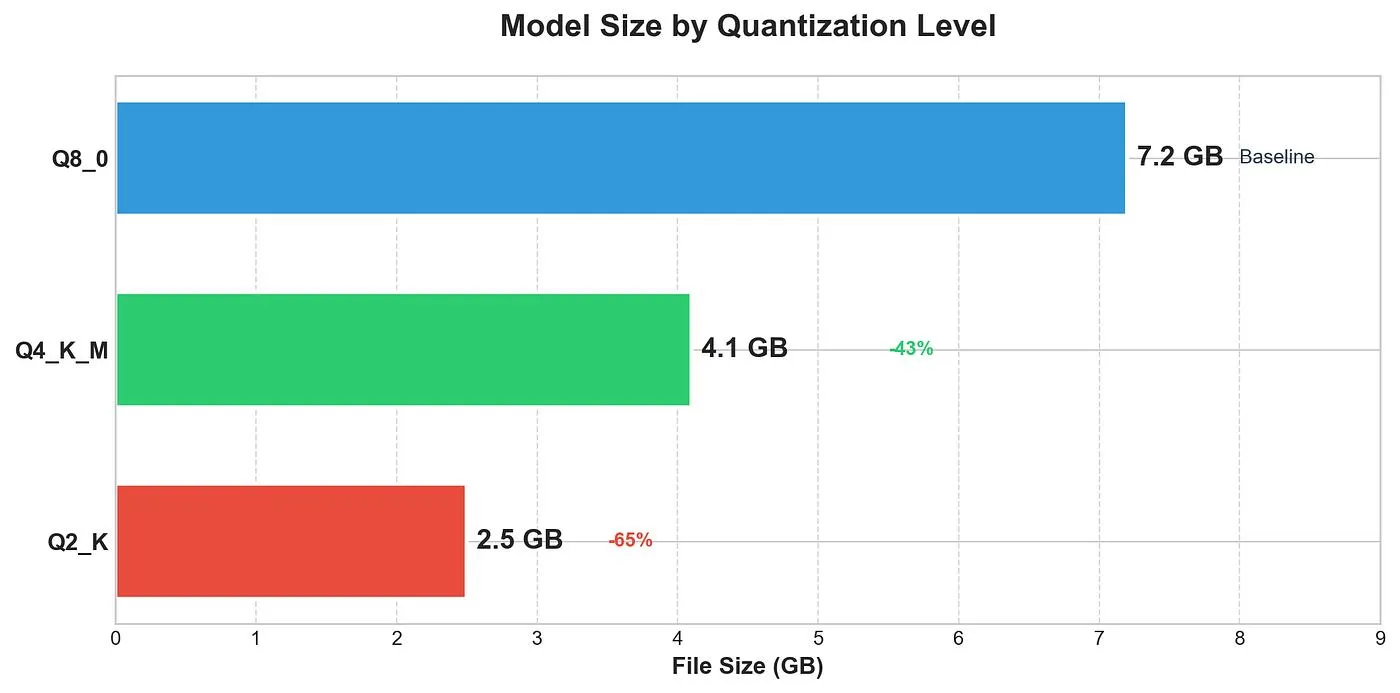
کاهش شدید حجم مدل ممکن است در نگاه اول جذاب باشد؛ بهویژه اگر بخواهید مدل بزرگی را روی کارت گرافیک دارای حافظه محدود اجرا کنید. با این حال، مدلهای دارای کوانتایز بسیار پایین ممکن است در استدلال، برنامهنویسی یا پیروی از دستورها ضعیفتر عمل کنند.
اگر یک مدل Q2 پاسخهای نادرست یا تکراری تولید میکند، همیشه لازم نیست مدل بزرگتری دانلود کنید. امتحان کردن نسخه Q4 یا Q5 از همان مدل میتواند نتیجه بهتری داشته باشد. در مقابل، اگر حافظه کافی ندارید، گاهی استفاده از یک مدل کوچکتر با کوانتایز بهتر از اجرای یک مدل بزرگ با افت کیفیت شدید است.
قالب چت چگونه دقت مدل هوش مصنوعی را تغییر میدهد؟
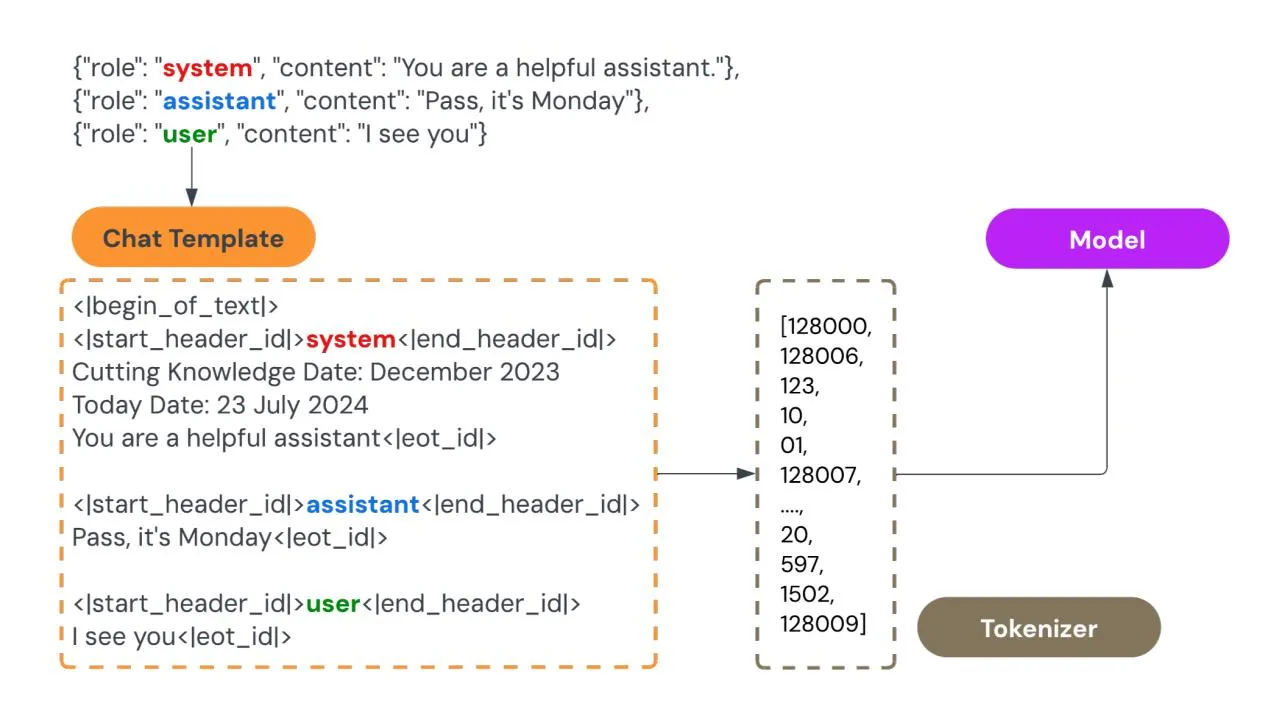
قالب چت یا Chat Template مشخص میکند پیام کاربر، دستورهای سیستمی و پاسخ مدل چگونه به قالب ورودی مورد انتظار مدل تبدیل شوند. این قالب باید با مدل انتخابشده سازگار باشد؛ زیرا مدلهای مختلف ممکن است از ساختارهای متفاوتی برای دریافت پیامها استفاده کنند.
حتی اگر مدل و فایل کوانتایز مناسبی داشته باشید، قالب اشتباه میتواند باعث شود پاسخها کیفیت مطلوبی نداشته باشند. این موضوع هنگام استفاده از مدلهای مختلف در ابزارهایی مانند محیطهای اجرای محلی اهمیت بیشتری پیدا میکند.
تنظیم قالب چت برای برنامهنویسی و کارهای روزمره
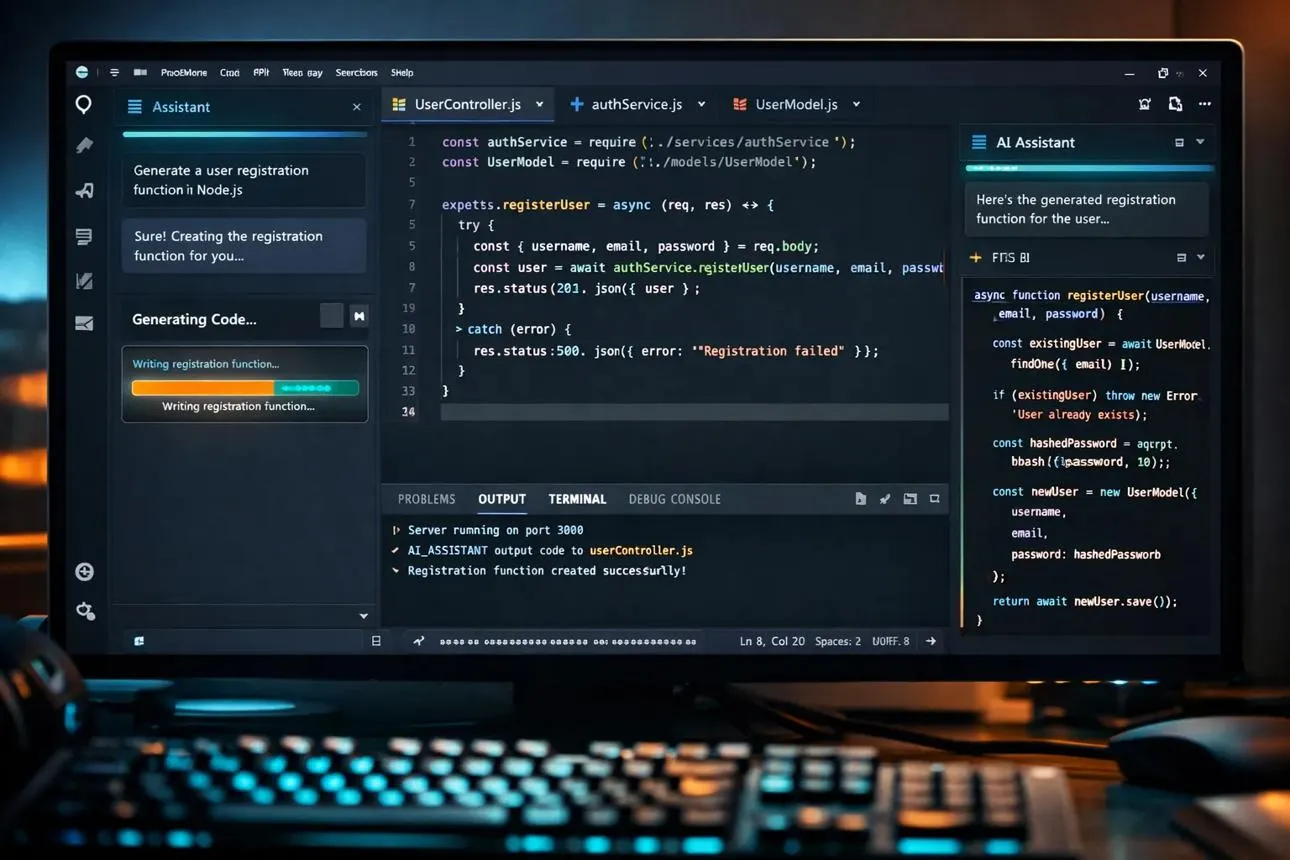
اگر از مدل برای برنامهنویسی استفاده میکنید، تنها تغییر میزان کوانتایز کافی نیست. باید بررسی کنید که قالب چت، نقش سیستم و تنظیمات اختصاصی مدل نیز درست انتخاب شده باشند.
برای بهبود نتیجه، این موارد را بررسی کنید:
- قالب اختصاصی مدل: قالبی را انتخاب کنید که برای همان مدل طراحی شده است.
- دستور سیستمی: اگر هدف شما برنامهنویسی است، مشخص کنید مدل باید نقش یک دستیار برنامهنویسی را داشته باشد.
- حالت تفکر: اگر مدل از تنظیمات مربوط به استدلال پشتیبانی میکند، فعال یا غیرفعال بودن آن را متناسب با وظیفه بررسی کنید.
- نسخه مدل: هنگام تغییر مدل، تنظیمات و قالب نسخه قبلی را بدون بررسی به مدل جدید منتقل نکنید.
چرا مدلهای MoE برای کامپیوترهای معمولی مناسباند؟
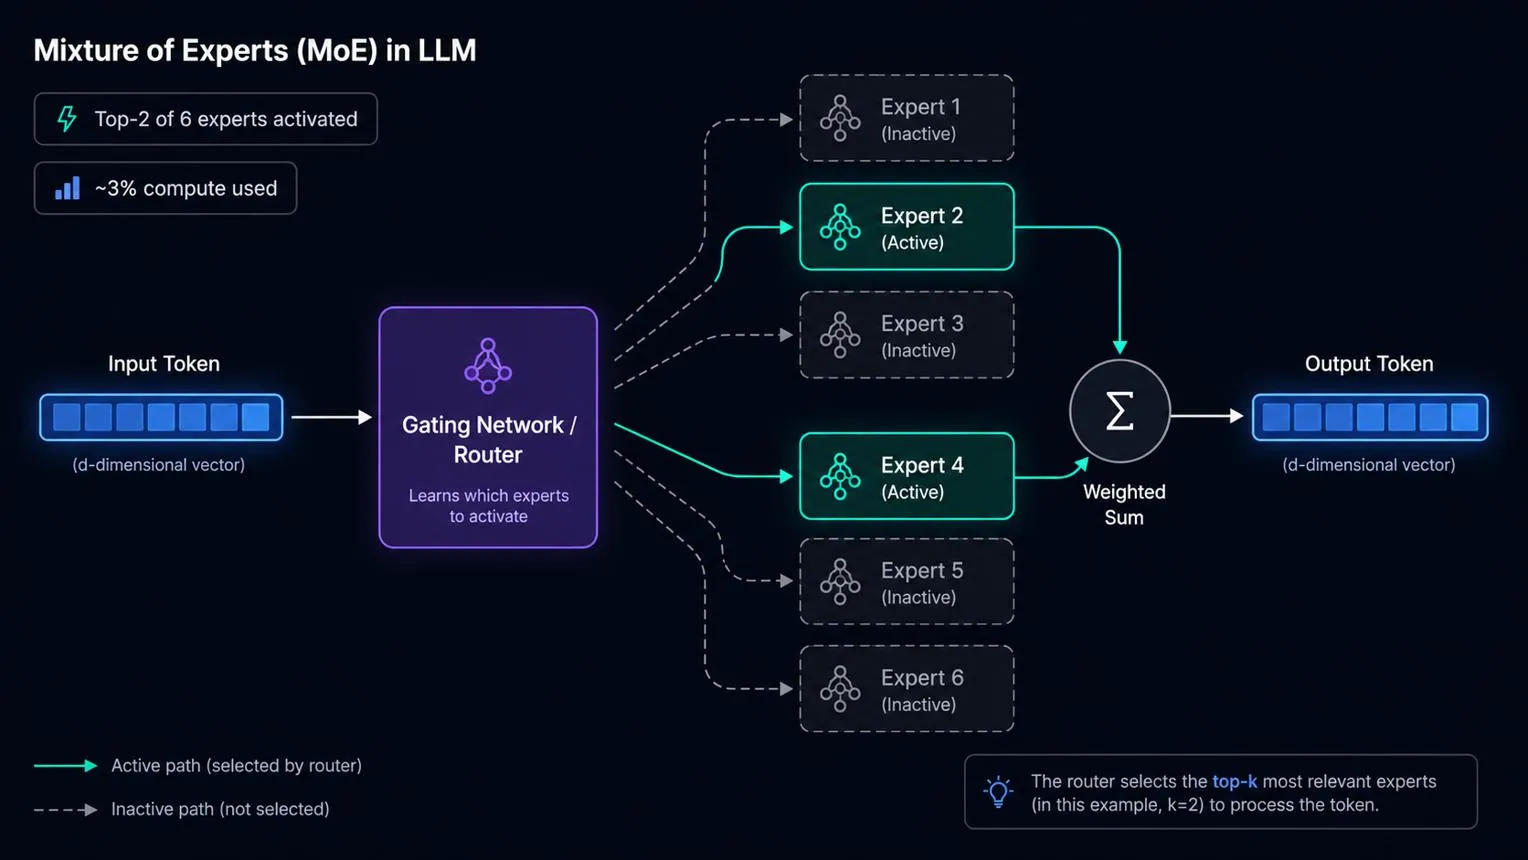
مدلهای متخصصان ترکیبی یا Mixture of Experts که با نام MoE شناخته میشوند، به جای فعال کردن تمام پارامترها برای هر توکن، از سازوکاری برای انتخاب بخشی از شبکه استفاده میکنند. به همین دلیل، تعداد پارامترهای فعال هنگام تولید پاسخ میتواند بسیار کمتر از تعداد کل پارامترهای مدل باشد.
این معماری میتواند اجرای مدلهای بزرگتر را از نظر محاسباتی کارآمدتر کند؛ اما به این معنا نیست که هر مدل MoE به حافظه کمی نیاز دارد. وزنهای غیرفعال هم باید در حافظه گرافیکی یا حافظه سیستم نگهداری شوند و انتقال آنها میان حافظهها ممکن است سرعت را کاهش دهد.
اجرای مدل MoE با حافظه گرافیکی محدود
در بعضی ابزارهای اجرا، از جمله llama.cpp، امکان انتقال بخشی از محاسبات یا وزنهای مدل به حافظه سیستم وجود دارد. این قابلیت به اجرای مدلهایی کمک میکند که تمام وزنهایشان در حافظه گرافیکی جا نمیشوند؛ اما عملکرد نهایی به پهنای باند حافظه، پردازنده، کارت گرافیک و تنظیمات اجرا وابسته است.
مدلهای خانواده Qwen و Gemma نمونههایی هستند که نسخهها و معماریهای متفاوتی دارند. پیش از دانلود، فقط به نام مدل یا تعداد کل پارامترها توجه نکنید؛ تعداد پارامترهای فعال، اندازه فایل کوانتایز و نیاز حافظه در زمان اجرا را هم بررسی کنید.
چگونه بهترین مدل هوش مصنوعی محلی را انتخاب کنیم؟
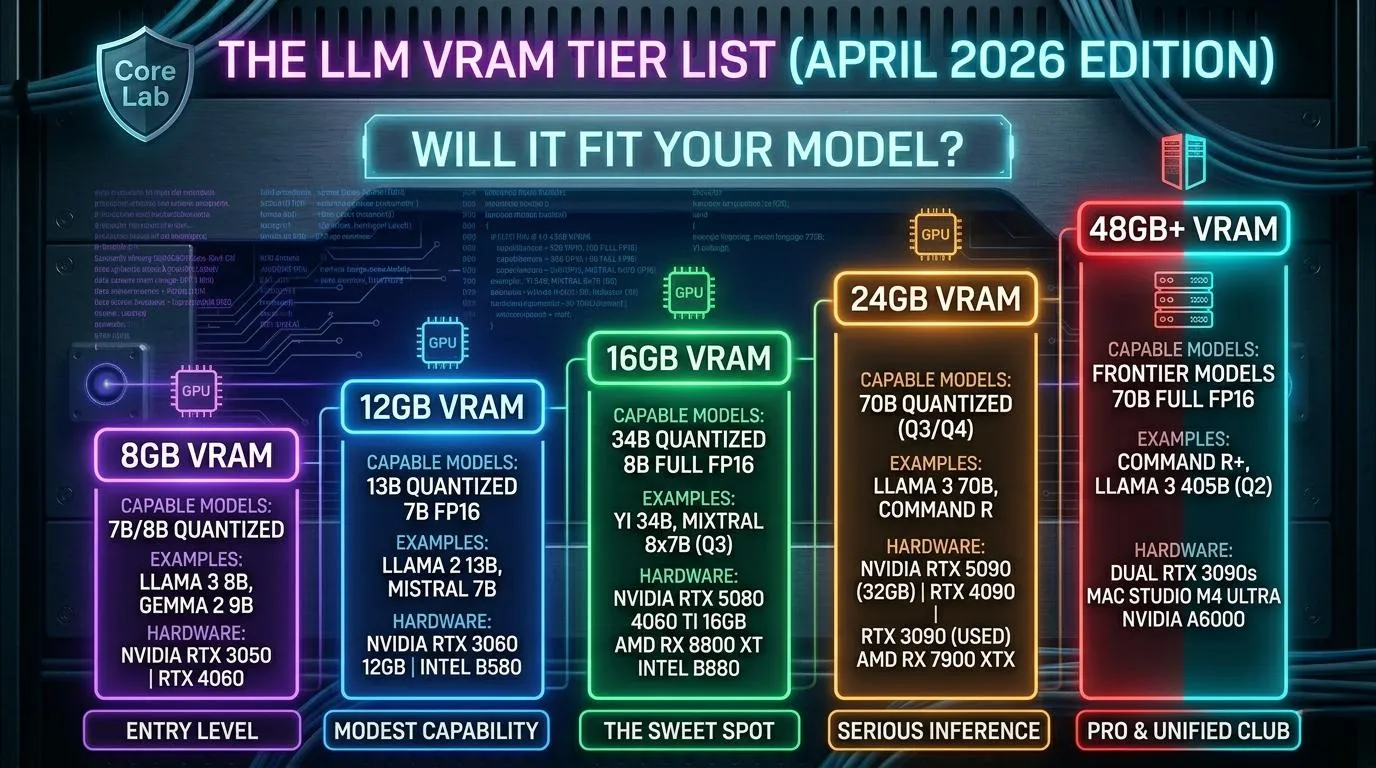
برای انتخاب مدل مناسب، ابتدا مقدار حافظه گرافیکی و حافظه سیستم را بررسی کنید. علاوه بر حجم وزنهای مدل، باید برای پنجره زمینه، حافظه موقت و سایر بخشهای برنامه نیز فضای کافی باقی بگذارید. بنابراین، مدلی که حجم فایل آن کمی کمتر از ظرفیت VRAM است، لزوماً بهطور کامل در حافظه گرافیکی اجرا نمیشود.
پیشنهاد کاربردی این است که ابتدا یک نسخه Q4 از مدلی متناسب با سختافزارتان امتحان کنید. اگر حافظه کافی باقی ماند و دقت بیشتری خواستید، نسخه Q5 را آزمایش کنید. اگر پاسخها نادرست یا تکراری بودند، قالب چت، دستور سیستمی و تنظیمات اجرایی را هم بررسی کنید؛ زیرا کوانتایز تنها عامل تعیینکننده کیفیت نیست.
اینتوتک