اجرای مدلهای هوش مصنوعی روی کامپیوتر شخصی به شما کمک میکند کنترل بیشتری روی دادهها، مدل انتخابی و نحوه استفاده از سختافزار داشته باشید. برای این کار، Ollama و llama.cpp دو ابزار محبوب هستند؛ اما با وجود هدف مشترک، روش کار و میزان کنترلی که در اختیار کاربر میگذارند تفاوت دارد.
اگر میخواهید بدون درگیری با تنظیمات پیچیده، مدل زبانی محلی اجرا کنید، Ollama نقطه شروع مناسبی است. در مقابل، اگر به تنظیم دقیق حافظه، استفاده از GPU و پارامترهای اجرای مدل نیاز دارید، llama.cpp میتواند انتخاب انعطافپذیرتری باشد.
Ollama؛ سادهترین راه برای اجرای هوش مصنوعی محلی
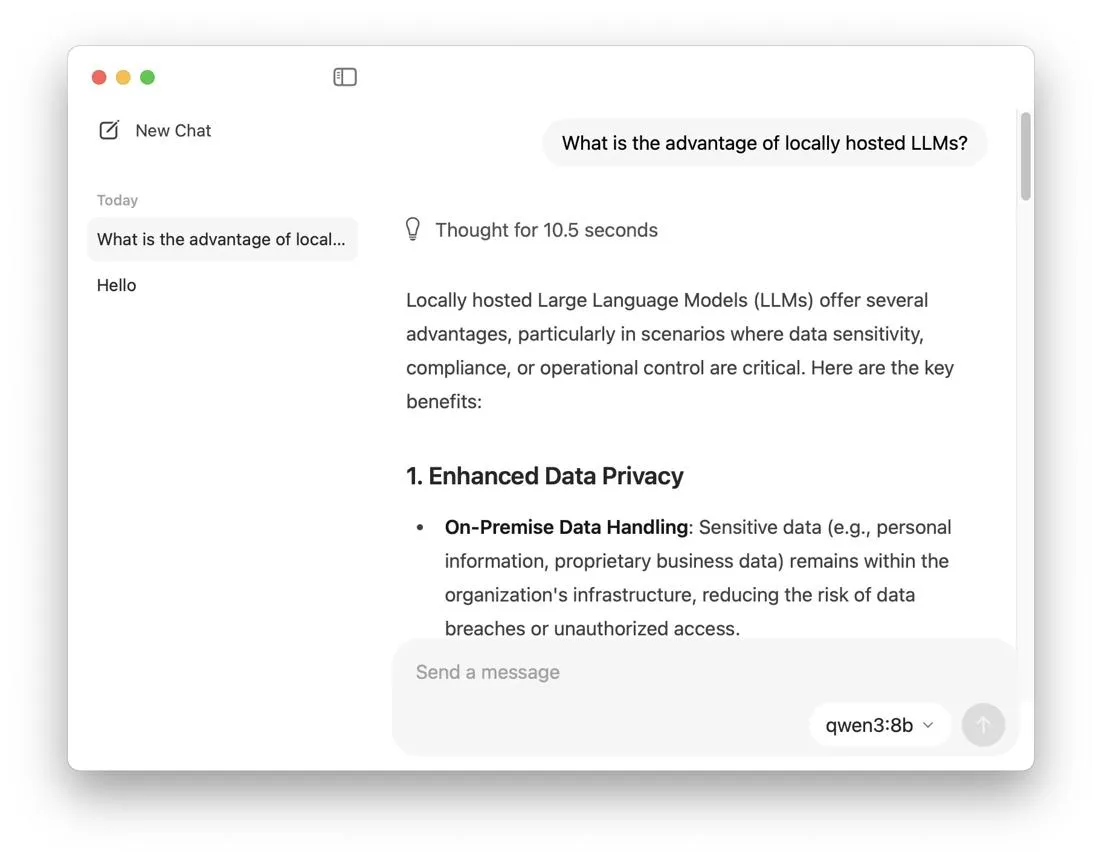
Ollama بخش زیادی از تنظیمات فنی اجرای مدلهای زبانی را مدیریت میکند. پس از نصب برنامه، میتوانید مدل موردنظر را دریافت کنید و از طریق ترمینال یا برنامههای سازگار با رابط برنامهنویسی آن با مدل تعامل داشته باشید. برای شروع، لازم نیست تمام جزئیات موتور استنتاج یا نحوه بارگذاری مدل را بشناسید.
برای دریافت و اجرای یک مدل، کافی است دستور متناسب با نام آن را در ترمینال وارد کنید. به عنوان مثال، برای اجرای مدل llama3.2 میتوانید از این دستور استفاده کنید:
ollama run llama3.2
Ollama مدل را در صورت نیاز دریافت میکند و سپس امکان گفتوگو با آن را فراهم میسازد. این ابزار همچنین سرویس محلی و API دارد؛ بنابراین میتوانید مدل را به بعضی رابطهای چت، ابزارهای کدنویسی و برنامههای دیگر متصل کنید.
مزیتهای مهم Ollama عبارتاند از:
- نصب و راهاندازی ساده برای کاربران تازهکار
- دریافت و مدیریت مدلها با دستورهای کوتاه
- امکان استفاده از مدلهای مختلف بدون تنظیم دستی همه اجزا
- فراهم کردن API برای اتصال به برنامههای سازگار
- مناسب بودن برای آزمایش مدلها و استفاده روزمره
با این حال، ساده بودن به معنی نداشتن تنظیمات پیشرفته نیست. Ollama امکان تغییر پارامترهایی مانند طول زمینه و گزینههای اجرای مدل را نیز فراهم میکند؛ اما برای بعضی تنظیمات خاص، لازم است با پیکربندی آن آشنا شوید.
محدودیتهای Ollama؛ چه زمانی به کنترل بیشتری نیاز دارید؟
با افزایش پیچیدگی کارها، ممکن است بخواهید نحوه اجرای مدل را دقیقتر کنترل کنید. یکی از تنظیمات مهم، طول زمینه یا Context Length است؛ یعنی میزان متنی که مدل میتواند در یک نوبت در نظر بگیرد. مقدار پیشفرض Ollama به نسخه، سختافزار و تنظیمات بستگی دارد و در همه سیستمها یکسان نیست.
افزایش طول زمینه برای تحلیل اسناد طولانی یا استفاده از عاملهای برنامهنویسی مفید است، اما حافظه بیشتری مصرف میکند. بنابراین، انتخاب مقدار بسیار بزرگ لزوماً باعث بهتر شدن عملکرد نمیشود؛ بهخصوص اگر حافظه کارت گرافیک یا RAM محدود باشد.
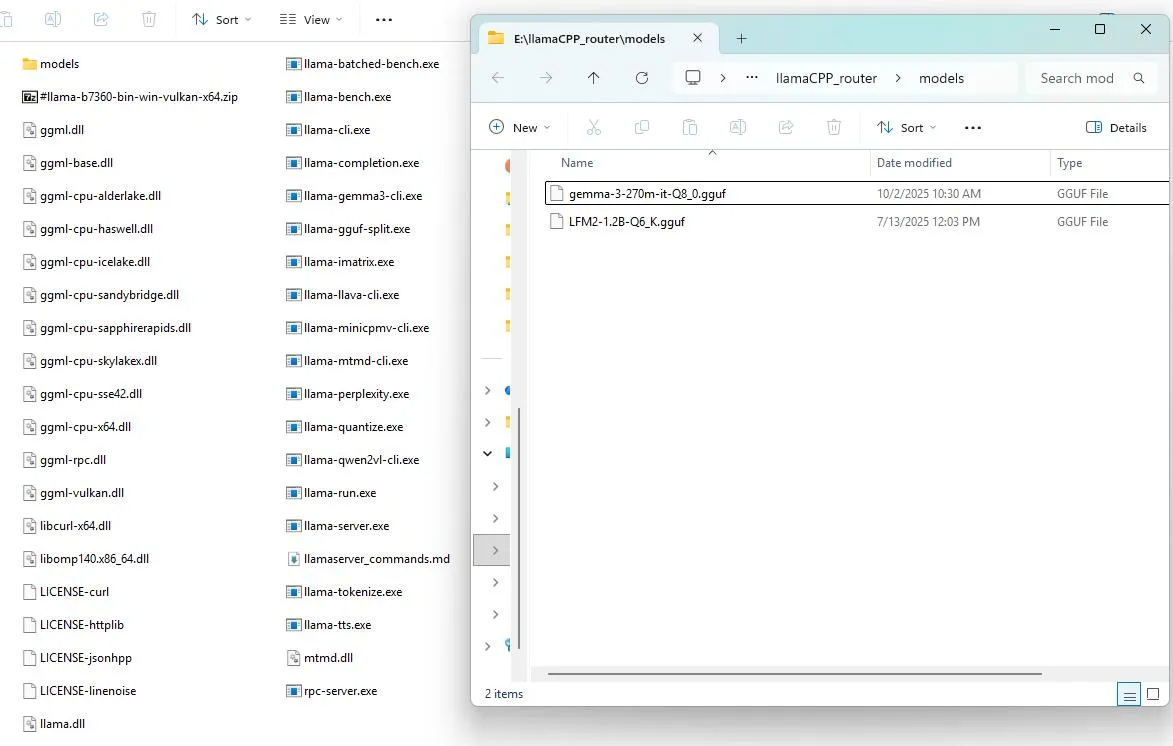
موضوع دیگر، دسترسی به فایلهای مدل است. Ollama مدلها را در ساختار ذخیرهسازی خودش مدیریت میکند و فایلهای آن همیشه مانند یک فایل مستقل GGUF در دسترس کاربر نیستند. در نتیجه، اگر بخواهید همان مدل را در موتور دیگری اجرا کنید، ممکن است لازم باشد نسخه سازگار آن را جداگانه تهیه کنید.
همچنین نباید فرض کرد که Ollama همیشه کندتر از llama.cpp است. سرعت واقعی به مدل، نسخه نرمافزار، تنظیمات، نحوه استفاده از GPU و نوع سختافزار بستگی دارد. تفاوت اصلی این است که Ollama بخش بیشتری از مدیریت اجرا را بهعهده میگیرد، در حالی که llama.cpp کنترل مستقیمتری ارائه میدهد.
llama.cpp؛ اجرای مستقیم مدل با تنظیمات پیشرفته
llama.cpp موتور استنتاجی متنبازی است که برای اجرای مدلهای زبانی روی سختافزارهای مختلف طراحی شده است. این ابزار از مدلهای سازگار با قالب GGUF پشتیبانی میکند و امکان تنظیم دقیقتری برای نحوه بارگذاری و اجرای آنها در اختیار شما میگذارد.
برای اجرای یک مدل محلی، معمولاً باید فایل مدل را انتخاب کنید و پارامترهایی مانند طول زمینه، میزان استفاده از GPU و تنظیمات تولید متن را متناسب با سختافزار خود تعیین کنید. این آزادی عمل برای کاربران حرفهای مفید است، اما در مقایسه با Ollama به آشنایی فنی بیشتری نیاز دارد.
از قابلیتهای مهم llama.cpp میتوان به این موارد اشاره کرد:
- تنظیم میزان انتقال لایههای مدل به حافظه GPU
- کنترل طول زمینه و پارامترهای تولید پاسخ
- پشتیبانی از روشهای مختلف کوانتیزهسازی برای کاهش مصرف حافظه
- اجرا روی CPU و سختافزارهای گرافیکی سازگار
- ارائه سرور داخلی با API سازگار با قالب OpenAI برای اتصال به ابزارهای دیگر
به عنوان مثال، اگر فایل مدل شما با نام model.gguf در دسترس باشد، در نسخههایی که دستور llama-cli را ارائه میکنند، میتوانید از این الگو استفاده کنید:
llama-cli -m model.gguf
برای اجرای سرور، نسخههای متداول llama.cpp نیز ابزار llama-server را ارائه میکنند. نام دستورها و گزینهها ممکن است بسته به نسخه نصبشده تفاوت داشته باشد.
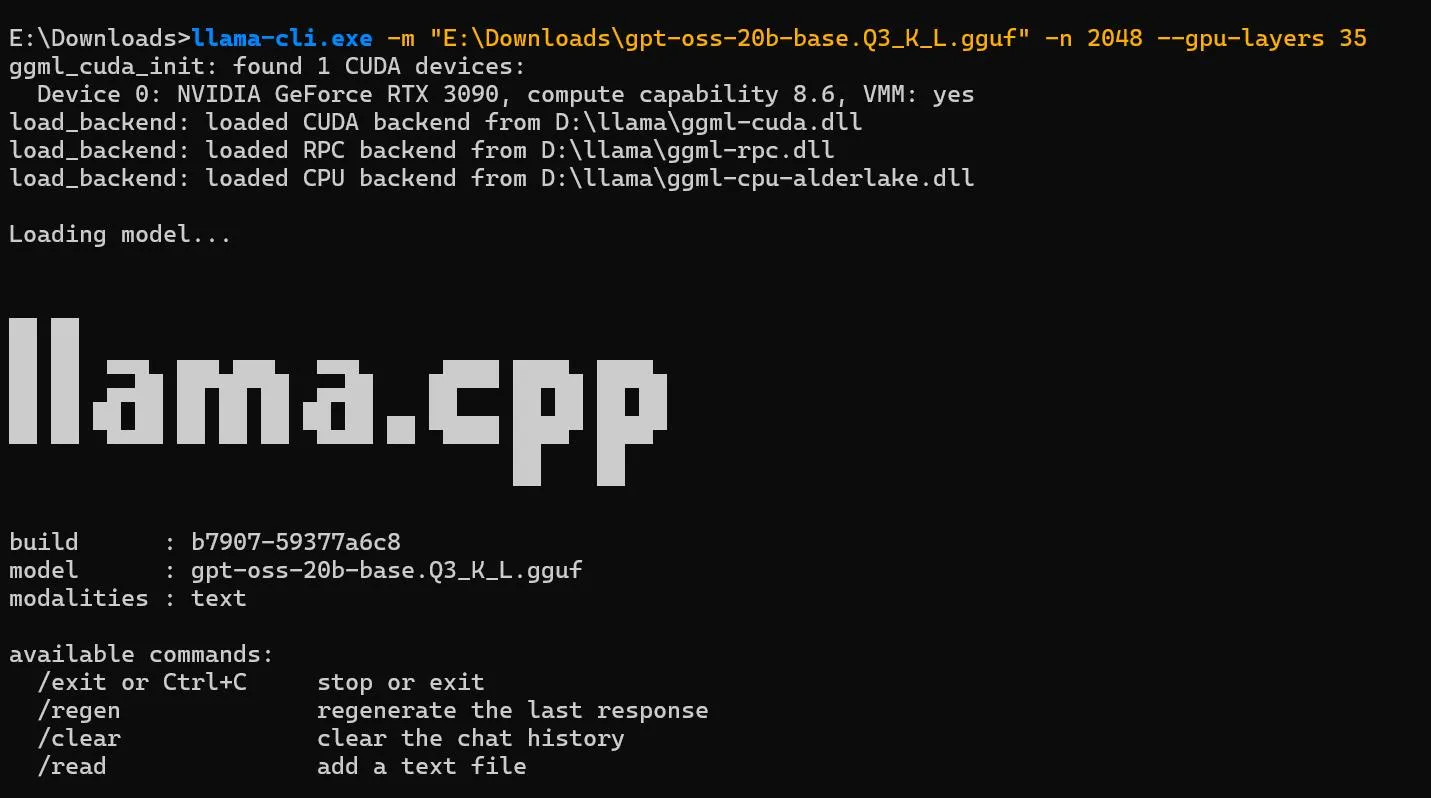
نکته مهم این است که llama.cpp بهصورت خودکار در همه شرایط سریعتر نیست. تنظیم نادرست یا انتخاب مدل نامتناسب با سختافزار میتواند سرعت را کاهش دهد یا مصرف حافظه را افزایش دهد. مزیت اصلی آن، کنترل بیشتر روی جزئیات اجراست؛ نه تضمین افزایش سرعت در تمام سیستمها.
Ollama یا llama.cpp؛ کدام گزینه برای شما بهتر است؟
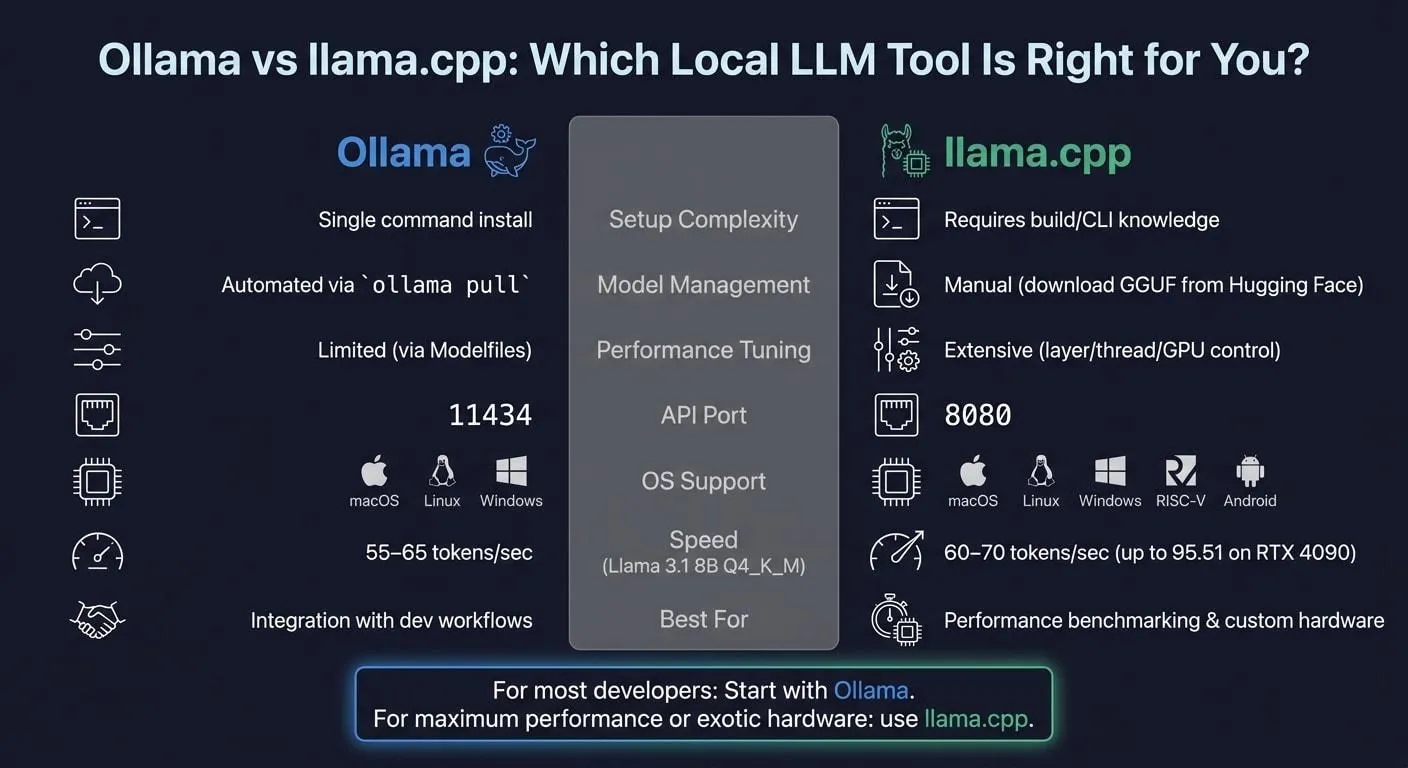
انتخاب بین این دو ابزار به تجربه شما، نوع استفاده و سختافزارتان بستگی دارد. اگر میخواهید سریع مدلهای مختلف را امتحان کنید، Ollama انتخاب راحتتری است. اگر میخواهید جزئیات اجرای مدل را خودتان کنترل کنید، llama.cpp ارزش بررسی دارد.
|
ویژگی |
Ollama |
llama.cpp |
|---|---|---|
|
راهاندازی اولیه |
سادهتر |
نیازمند تنظیمات بیشتر |
|
مدیریت مدلها |
مدیریت داخلی و آسان |
کنترل مستقیمتر روی فایلهای سازگار |
|
تنظیمات پیشرفته اجرا |
در دسترس، با سطح انتزاع بیشتر |
کنترل دقیقتر |
|
استفاده از GPU |
مدیریت خودکار در محیطهای پشتیبانیشده |
تنظیمات مستقیمتر برای بارگذاری |
|
اتصال به برنامهها |
API محلی |
سرور و API سازگار |
|
مناسب برای |
شروع سریع و استفاده روزمره |
کاربران حرفهای و تنظیم دقیق |
پیشنهاد کاربردی: اگر تازه میخواهید هوش مصنوعی را بهصورت محلی اجرا کنید، با Ollama شروع کنید. اگر بعداً به تنظیمات دقیقتر نیاز داشتید، llama.cpp را با همان مدل یا نسخه GGUF سازگار آزمایش کنید. برای مقایسه منصفانه، مدل یکسان، تنظیمات مشابه و وظایف مشابه را به کار ببرید و سرعت تولید پاسخ و مصرف حافظه را بسنجید.
به خاطر داشته باشید که اجرای محلی میتواند ارسال دادهها به سرویسهای ابری را کاهش دهد، اما بهتنهایی امنیت کامل را تضمین نمیکند؛ برنامههای متصل، APIهای در دسترس شبکه و تنظیمات سیستم نیز اهمیت دارند.
اینتوتک